Preguntas frecuentes sobre IA
¿Qué es un modelo de decisión?
Una taza rota conecta las respuestas tipadas de la IA, las probabilidades calibradas y el costo de actuar. Por qué una respuesta probable no elige la acción por ti.
Imagina que le escribiste a una tienda en línea porque tu taza llegó rota y, en menos de un segundo, llegó la respuesta: «Envíanos una foto del daño». Otra clienta, con un mensaje casi idéntico, recibió el reembolso al instante. Un tercer cliente esperó hasta el día siguiente a que le respondiera una persona. Nadie leyó los tres mensajes para sopesarlos; lo hizo el software, en dos pasos. Primero, algo estimó qué tan probable era que cada solicitud estuviera cubierta por la política de la tienda. Después, otra cosa eligió qué hacer con esa estimación.
Un modelo de decisión puede ser dos cosas: un modelo de IA que devuelve respuestas tipadas con probabilidades, o una descripción formal de una elección, con sus alternativas, incertidumbre, consecuencias y costos o preferencias. En los productos de IA que veremos aquí, hace el primer trabajo de nuestra tienda: lee un mensaje o registro y devuelve valores dentro de un formato de respuesta definido de antemano, sin redactar una contestación. El sentido formal proviene del análisis de decisiones y describe el segundo paso. Un sistema como el de la tienda necesita ambos, y confundirlos es la manera más fácil de malinterpretar lo que prometen estos nuevos modelos.
Sigamos la taza a través de los dos.
El ejemplo comienza en casa del cliente, con una taza que llegó rota. Reembolsarla, pedir una foto y pasar el caso a una persona son tres acciones posibles. Ilustración conceptual.
¿De dónde viene «System One»?
TypeSafe AI, una empresa que desarrolla modelos para automatizar software, presentó su primer «System One model», Jev, el 15 de septiembre de 2026. La empresa atribuye explícitamente la inspiración de ese nombre al psicólogo y premio Nobel de Economía de 2002 Daniel Kahneman y a su libro Thinking, Fast and Slow, conocido en español como Pensar rápido, pensar despacio (Almeida, 2026 (se abre en una pestaña nueva)).
El Sistema 1 de Kahneman funciona «automatically and quickly» —«automática y rápidamente»—: pensemos en la empleada que reconoce de inmediato un reclamo habitual por daños. El Sistema 2 se ocupa de «effortful mental activities» —«actividades mentales que requieren esfuerzo»—, como cuando esa empleada revisa una excepción inusual de la política. Ambos intervienen en las decisiones (Kahneman, 2011, cap. 1 (se abre en una pestaña nueva); traducciones propias de los fragmentos). Jev toma la imagen del juicio rápido; un gran modelo de lenguaje (LLM) que desarrolla pasos intermedios de razonamiento ofrece una analogía con la deliberación. Es una comparación de funciones, no un mecanismo cognitivo compartido. La probabilidad de Jev todavía necesita la regla de costos de la tienda para convertirse en un reembolso.
Reconocer un caso habitual y examinar una excepción: dos momentos de la analogía de la empleada para los sistemas de Kahneman. Ambos pueden contribuir a una decisión.
El juicio rápido también tiene una debilidad en la explicación de Kahneman: puede producir sesgos y una confianza injustificada (Kahneman, 2011 (se abre en una pestaña nueva)). TypeSafe reconoce que el Sistema 1 se asocia con errores y sostiene que sus modelos pueden hacerse más fiables (Almeida, 2026 (se abre en una pestaña nueva)). Para nuestra tienda, la rapidez deja abierta otra pregunta: ¿cuánto debemos confiar en el número?
Lo que devuelve en lugar de texto
Una solicitud tiene dos partes. El estado (state) es lo que el modelo debe examinar: el mensaje del cliente, el registro del pedido, la política de reembolsos. Las preguntas se tipan de antemano, y cada una admite un tipo fijo de respuesta. Jev ofrece tres: Choice, una elección entre hasta 255 opciones con nombre; Score, una posición en una escala ordenada; y una pregunta de sí o no que TypeSafe llama Noul, respondida con la probabilidad del «sí» (Almeida, 2026 (se abre en una pestaña nueva); TypeSafe AI, s. f.-a (se abre en una pestaña nueva)). Para nuestra tienda basta un Noul:
{
  "model": "jev-latest",
  "state": {
    "message": "Mi taza llegó rota. Quisiera un reembolso.",
    "refund_policy": "Los artículos dañados durante el envío se reembolsan por completo."
  },
  "questions": {
    "covered": {
      "type": "noul",
      "instructions": "¿La situación de `message` está cubierta por `refund_policy`?"
    }
  }
}
La respuesta a covered no contiene ninguna oración que haya que interpretar; solo un valor como {"type": "noul", "noul": 0.9}.
Esa diferencia importa más de lo que parece. Un modelo de lenguaje generativo al que se le hace la misma pregunta puede escribir su respuesta token a token. Sin una restricción de salida, el programa podría recibir «depende» o una explicación en vez de una etiqueta. Los modos de salida estructurada pueden limitar la respuesta a un esquema, incluido un conjunto fijo de etiquetas. La diferencia aquí también está en cómo se calcula la respuesta: puntuar directamente las opciones permitidas en vez de generar una secuencia. Ni una confianza escrita como texto ni la probabilidad de un clasificador están bien calibradas por el simple hecho de ser números. La respuesta de un modelo de decisión no puede caer fuera de las opciones declaradas: es una garantía sobre el formato, que TypeSafe presenta como cierta por construcción y no como un resultado medido (Almeida, 2026 (se abre en una pestaña nueva)). Esa garantía limitada al formato es lo que conviene retener de su afirmación de que Jev no puede alucinar. La respuesta todavía puede ser incorrecta; lo que no puede es ser una cuarta categoría que nadie definió.
Jev actualmente solo acepta texto (TypeSafe AI, s. f.-c (se abre en una pestaña nueva)). En nuestro ejemplo, pedir una foto inicia una comprobación aparte, a cargo de una persona o de un componente que pueda examinar imágenes.
De la información sin estructurar a las probabilidades de respuestas posibles. Ilustración conceptual de un modelo de decisión de IA.
Responder sin escribir
¿Cómo responde un modelo sin escribir? TypeSafe no ha publicado la arquitectura de Jev. Describe una arquitectura nueva, un muestreador paralelo que produce todas las respuestas en una sola consulta y un método de postentrenamiento al que llama Reinforcement Learning for Calibrated Decisions, o RLCD (Almeida, 2026 (se abre en una pestaña nueva)).
Cloudflare, una empresa de infraestructura de internet, usa «modelo de decisión» para Jev y sus propios modelos Clef. Publicó Clef y Clef-flash con pesos abiertos el 1 de octubre de 2026 y describe su enfoque con más detalle: un modelo de lenguaje lee toda la entrada en una sola pasada sin generar nada, y un componente adicional de puntuación evalúa las opciones válidas en paralelo a partir de esa representación interna (Chen et al., 2026 (se abre en una pestaña nueva)).
Convertir puntuaciones en probabilidades es el último paso conocido de un clasificador. Si la opción recibe una puntuación , la función softmax convierte las puntuaciones en probabilidades positivas que suman 1:
La exponencial da un peso positivo a cada opción; dividir entre la suma normaliza esos pesos. Una diferencia entre puntuaciones se convierte en una razón entre probabilidades. Con tres opciones puntuadas 2.0, 0.5 y −1.0 (valores inventados), las probabilidades son 0.786, 0.175 y 0.039. Esto ilustra un mecanismo de puntuación, no la implementación no publicada de Jev. Evitar la generación secuencial elimina trabajo que un modelo generativo realizaría para cada token de salida. Eso puede reducir la latencia, pero el total también depende del tamaño del modelo, la longitud de la entrada, el hardware, la carga y la red. TypeSafe reporta para Jev entre 70 y 500 ms de extremo a extremo y cobra solo los tokens de entrada; son cifras del proveedor, no tiempos medidos aquí (Almeida, 2026 (se abre en una pestaña nueva)).
TypeSafe también deriva un valor confidence separado de las probabilidades de algunas respuestas (nota 1).
El intercambio es deliberado. Un modelo de decisión no puede explicarse en prosa, resumir ni producir una opción que olvidaste listar. Responde las preguntas que escribiste, sobre las opciones que escribiste.
Cuando 0.9 significa 0.9
El riesgo de equivocarse con confianza nos devuelve a Kahneman: el capítulo 22 explica por qué sentirnos seguros de una intuición es una guía poco fiable de su validez (Kahneman, 2011, cap. 22 (se abre en una pestaña nueva)). En nuestra tienda, podemos contrastar las probabilidades del modelo con reclamos ya resueltos. Para esta pregunta de sí o no, un modelo está calibrado cuando, entre los reclamos a los que asigna una probabilidad de cobertura de 0.9, alrededor del 90 % están realmente cubiertos; entre los que reciben 0.3, lo están alrededor del 30 %. Comparamos la probabilidad del evento con su frecuencia observada; una probabilidad baja no es por sí misma una respuesta incorrecta. Un estudio de 2017 sobre clasificadores de imágenes y documentos encontró que las redes profundas modernas, aunque acertaban más que sus predecesoras, se habían vuelto sistemáticamente demasiado confiadas. Midió la brecha con el error de calibración esperado (expected calibration error): la distancia promedio entre la confianza declarada y la exactitud observada en grupos de predicciones, ponderada por el tamaño de cada grupo (Guo et al., 2017 (se abre en una pestaña nueva)).
¿Cómo se entrena a un modelo para que sea honesto con las probabilidades? Evaluándolo con una regla bajo la cual la honestidad compensa. La puntuación de Brier de un pronóstico de sí o no compara la probabilidad declarada con el resultado , que vale 1 si el evento ocurrió y 0 si no:
Menos es mejor. Supongamos que el 80 % de los mensajes como el nuestro están realmente cubiertos. Declarar 0.8 da una puntuación esperada de . Exagerarla como 1.0 da 0.20; subestimarla como 0.6 también da 0.20. Solo la probabilidad verdadera minimiza la penalización esperada, y eso hace que la regla sea estrictamente propia (Gneiting & Raftery, 2007 (se abre en una pestaña nueva)); la nota 2 muestra el caso general. Cloudflare informa que añadió una pérdida de Brier al entrenar Clef para afinar su calibración. También usa el nombre RLCD para un objetivo secundario de optimización que sí describe (Chen et al., 2026 (se abre en una pestaña nueva)). TypeSafe afirma que su RLCD premia probabilidades honestas (Almeida, 2026 (se abre en una pestaña nueva)), pero no ha publicado suficiente detalle para saber si ambos métodos coinciden. Una regla propia recompensa las probabilidades correctas en promedio; datos finitos y un modelo imperfecto todavía pueden dejar errores de calibración.
La calibración es una propiedad de muchas respuestas, no una promesa sobre una sola. Además, vale para el tipo de datos en que se midió. TypeSafe señala que el inglés es el idioma en que Jev rinde mejor y que otros idiomas se manejan peor, algo que conviene recordar con mensajes en español o en cualquier otro idioma. Su propia lista de debilidades incluye la lectura literal de las instrucciones, el conteo y las comparaciones de fechas poco fiables, y respuestas que un texto adversarial en el estado puede desviar (TypeSafe AI, s. f.-b (se abre en una pestaña nueva); TypeSafe AI, s. f.-c (se abre en una pestaña nueva)). Esta última debilidad importa para nuestra tienda, porque el mensaje lo escribe la persona que se beneficia de la decisión. Una probabilidad medida con datos ajenos es un punto de partida; la que cuenta se mide con tus propios casos.
De la probabilidad a la acción
Supongamos que el modelo reporta 0.90 para nuestra taza. ¿Debe la tienda reembolsarla? La probabilidad no lo dice. Lo que responde la pregunta es el costo de equivocarse en cada dirección, junto con las acciones disponibles.
Nuestra tienda tiene tres acciones, con costos inventados para el ejemplo. Contamos las pérdidas adicionales frente a resolver correctamente el reclamo; un reembolso que corresponde por política no se trata como el costo de un error. Reembolsar un reclamo que la política no cubre hace perder el pedido de USD 40. Pedir una foto cuesta alrededor de USD 1 en fricción y, suponemos, detiene nueve de cada diez reclamos no cubiertos, lo que deja una pérdida esperada de USD 4 por reclamo no cubierto. Suponemos que la comprobación por foto nunca bloquea un reclamo cubierto. Enviar el caso a una persona cuesta USD 3 en tiempo de personal, y suponemos que la persona siempre acierta. Si es la probabilidad que el modelo asigna a que el reclamo esté cubierto y es la probabilidad de que no lo esté, el costo esperado de cada acción es:
- Reembolsar de inmediato: .
- Pedir una foto: .
- Enviar a una persona: .
La regla general es elegir la acción de menor costo esperado, ponderando cada estado posible del mundo por su probabilidad dado lo que observamos (Elkan, 2001 (se abre en una pestaña nueva)):
Aquí es el mensaje, recorre «cubierto» y «no cubierto», es lo que aporta el modelo de decisión y es el costo de la acción cuando la verdad es . La tabla aplica la regla a cuatro mensajes que recibieron probabilidades distintas. Cada fila muestra el costo esperado de las tres acciones en USD; decide el menor.
| P(cubierto) | Reembolsar | Foto | Persona | Acción |
|---|---|---|---|---|
| 0.99 | 0.40 | 1.04 | 3.00 | Reembolsar |
| 0.90 | 4.00 | 1.40 | 3.00 | Foto |
| 0.60 | 16.00 | 2.60 | 3.00 | Foto |
| 0.30 | 28.00 | 3.80 | 3.00 | Persona |
Todos los costos son ilustrativos. El límite superior exacto es , aproximadamente 97.22 %. Por encima, reembolsar; entre 50 % y ese límite, pedir una foto; por debajo de 50 %, enviar el caso a una persona. En los límites hay empate: para este ejemplo elegimos persona en 50 % y foto en (nota 3). La taza con 0.90 recibe una solicitud de foto aunque el modelo la considere muy probablemente cubierta: si esa probabilidad está bien calibrada, uno de cada diez reembolsos automáticos iría a un reclamo no cubierto, y la foto tiene menor costo esperado bajo nuestros supuestos.
Ahora quitemos la opción de la foto. Con solo «reembolsar» y «persona», el límite pasa a 92.5 %. Añadir una acción intermedia no cambió ninguna probabilidad y, sin embargo, subió el umbral de los reembolsos automáticos casi cinco puntos porcentuales. Los umbrales pertenecen a la decisión, no al modelo: dependen del menú de acciones y de lo que cuesta cada error. La documentación de TypeSafe apunta lo mismo cuando recomienda umbrales de confianza más estrictos para acciones irreversibles que para acciones inofensivas, con la tolerancia al riesgo escrita en el código de la aplicación (TypeSafe AI, s. f.-a (se abre en una pestaña nueva)).
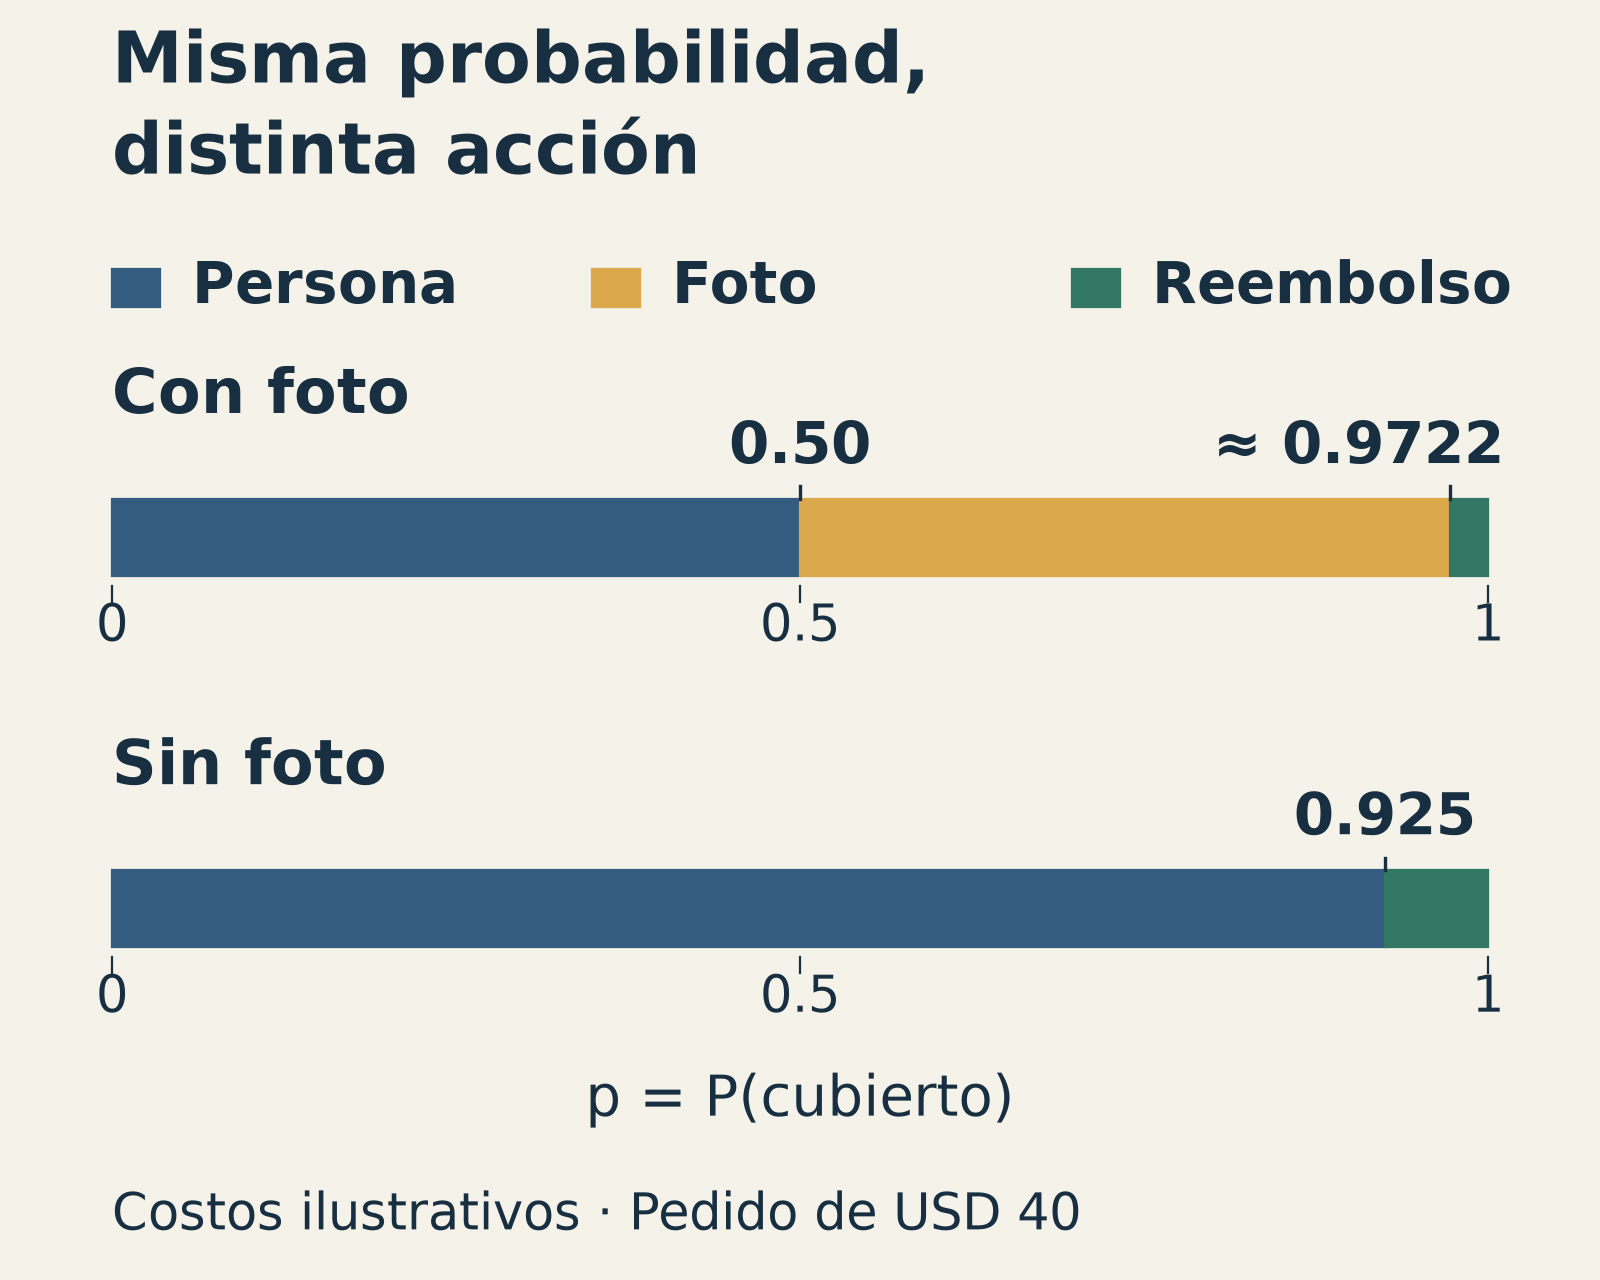
Zonas de decisión ilustrativas, calculadas con los costos del ejemplo. Con la misma probabilidad de 0.95, añadir la opción de foto cambia la acción elegida de reembolso a foto. Los empates siguen la convención de la nota 3.
¿Qué tan antiguo es un modelo de decisión?
Ronald A. Howard le dio nombre al análisis de decisiones (decision analysis) en un artículo de 1966 que proponía aplicar de forma sistemática la teoría de la decisión a elecciones reales (Howard, 1966/1983 (se abre en una pestaña nueva)). La teoría de la decisión es anterior. Esa disciplina representa elecciones como la de la tienda con diagramas de influencia: un rectángulo para la decisión (reembolsar, foto, persona), un óvalo para la incertidumbre (¿está cubierto el reclamo?), un nodo para el valor que se optimiza y flechas que representan información disponible para decidir o dependencias entre variables (Howard & Matheson, 1984/2005 (se abre en una pestaña nueva)). En ese vocabulario, el modelo de decisión es el diagrama completo. Los nuevos modelos de IA ocupan un óvalo: estiman una incertidumbre a partir de texto difícil de cubrir con reglas escritas a mano.
En el software empresarial, el sentido antiguo tiene una forma muy concreta. Decision Model and Notation, o DMN, es un estándar del Object Management Group, un consorcio de estándares de la industria, para expresar decisiones como diagramas y lógica ejecutable, incluidas tablas de decisión que enumeran condiciones y resultados fila por fila. Su primera versión formal se adoptó en septiembre de 2015. La versión 1.6 se adoptó en septiembre de 2026 y seguía siendo la versión formal más reciente al 11 de octubre de 2026 (Object Management Group, 2026 (se abre en una pestaña nueva)). Una regla de reembolso escrita en DMN podría decir que un daño reportado dentro de 30 días en un artículo de menos de USD 50 se reembolsa. Esas reglas las escriben personas; no se aprende nada. Las dos tradiciones se combinan con naturalidad: una tabla DMN puede tomar como una entrada más la probabilidad que produce un modelo de decisión. Los árboles de decisión añaden otro nombre que se solapa; la nota 4 separa sus dos sentidos habituales.
La capacidad que empaquetan los nuevos modelos es más joven que la disciplina, pero más antigua que el nombre. Elegir entre etiquetas descritas con palabras, sin ejemplos etiquetados de la tarea, tiene su propia historia en la investigación. Un estudio de 2008 la llamó clasificación sin datos (dataless classification): los nombres de las etiquetas, interpretados con conocimiento de Wikipedia, bastaban a menudo para clasificar documentos sin ejemplos etiquetados. Al añadir documentos sin etiquetar, los resultados se acercaban a los de un clasificador supervisado entrenado con 100 ejemplos etiquetados (Chang et al., 2008 (se abre en una pestaña nueva)). En 2019, otro estudio replanteó la clasificación de texto zero-shot, es decir, sin ejemplos de entrenamiento para la tarea, como un problema de implicación: ¿el texto implica una afirmación como «este texto trata de deportes»? Ese planteamiento permitió puntuar en un mismo marco etiquetas de tipos distintos, como temas, emociones o situaciones (Yin et al., 2019 (se abre en una pestaña nueva)). Nuestro Noul es una pregunta de implicación en ese sentido: ¿el mensaje, leído junto a la política, implica que el reclamo está cubierto? Los grandes modelos de lenguaje generalizaron después el enfoque. La probabilidad que un modelo de lenguaje asigna al texto de cada opción puede servir como la puntuación de esa opción, y el primer prototipo de Cloudflare partió de ahí antes de entrenar Clef (Chen et al., 2026 (se abre en una pestaña nueva)).
Lo reciente es la forma de empaquetar estas capacidades y ofrecerlas a quienes desarrollan software. TypeSafe lanzó Jev el 15 de septiembre de 2026. El 1 de octubre, Cloudflare publicó Clef con pesos abiertos y escribió que los clasificadores existían desde hacía tiempo y que la novedad estaba en trabajar sobre cualquier entrada sin reentrenar para cada nuevo conjunto de categorías (Almeida, 2026 (se abre en una pestaña nueva); Chen et al., 2026 (se abre en una pestaña nueva)). Entre esos lanzamientos, OpenAI anunció Decisions API en DevDay el 29 de septiembre de 2026: una interfaz que utiliza su modelo Luna para responder preguntas predefinidas con un conjunto finito de respuestas posibles, a partir de texto o imágenes. El anuncio describía una vista previa limitada (OpenAI, 2026 (se abre en una pestaña nueva)). Al 11 de octubre de 2026, esos lanzamientos y anuncios de productos tienen entre 10 y 26 días: unas semanas. El análisis de decisiones lleva 60 años con ese nombre y el estudio de clasificación sin datos tiene 18 años. La respuesta depende de a cuál de esas tres historias nos refiramos.
Enseñarle tu tienda
Todas las probabilidades hasta aquí salieron de un modelo general que lee mensajes de una tienda que nunca ha visto. Especializar un modelo de decisión significa mejorar lo que dice sobre tus casos, y hay cuatro niveles, ordenados más o menos por costo.
El primero no toca el modelo. La pregunta misma es una palanca: qué entra en el estado, cómo se redactan las instrucciones y qué significa cada opción. TypeSafe sirve los mismos pesos a todas las cuentas y recomienda adaptar Jev a un dominio a través de la solicitud, no de pesos personalizados (TypeSafe AI, s. f.-c (se abre en una pestaña nueva)). Los costos son otra palanca, y ya viven en tu código. Si la taza se convierte en un jarrón de USD 120, y la foto sigue deteniendo nueve de cada diez reclamos no cubiertos, el umbral del reembolso automático sube de 97.22 % a 99.07 %, y el límite para enviar un caso a una persona sube de 50 % a 83.33 %. No se reentrenó nada.
El segundo nivel recalibra las probabilidades sin cambiar su orden. Supongamos que etiquetas una muestra de reclamos pasados y descubres que, entre los mensajes a los que el modelo dio 0.90, solo tres de cada cuatro estaban realmente cubiertos. El escalado por temperatura (temperature scaling) puede corregir parte de esa descalibración con un solo número, , ajustado sobre una muestra etiquetada reservada para calibración y comprobado después con casos de evaluación separados. Para una respuesta de sí o no, divide entre el logaritmo de la razón de probabilidades (log-odds) de la probabilidad declarada y convierte el resultado de nuevo en probabilidad:
En este ejemplo inventado, una temperatura de 2 coincide con esa observación puntual: convierte 0.90 en exactamente 0.75, y 0.99 en 0.909. En nuestra tienda, ese segundo mensaje ya no recibiría un reembolso automático; queda por debajo de 97.22 % y recibe una solicitud de foto. Dividir entre un positivo conserva el signo y el orden de los log-odds, así que la respuesta más probable sigue siéndolo; solo se mueve la confianza. Todavía hay que comprobar con casos reservados para evaluación si calibra los demás rangos de probabilidad. El estudio de calibración de 2017 encontró que este método de un solo parámetro era sorprendentemente eficaz con clasificadores neuronales (Guo et al., 2017 (se abre en una pestaña nueva)). Laya, un modelo de decisión con pesos abiertos publicado por ConvAI Innovations, informa que ajustar una temperatura por tipo de pregunta con datos del dominio redujo su error de calibración esperado de 0.466 a 0.081, una cifra de su propio desarrollador (ConvAI Innovations, s. f. (se abre en una pestaña nueva)).
El tercer nivel entrena algo pequeño encima del modelo. TypeSafe sugiere descomponer los juicios amplios en preguntas atómicas y entrenar un modelo clásico que use como entradas las probabilidades de Jev (TypeSafe AI, s. f.-c (se abre en una pestaña nueva)). En nuestra tienda, varios Nouls podrían preguntar por separado si el mensaje describe un daño durante el envío y si describe un cambio de opinión. Una regresión logística, un modelo estadístico sencillo que pondera cada entrada y devuelve una probabilidad, entrenada con reclamos ya resueltos aprendería cuánto debe pesar cada respuesta. El modelo de decisión queda como está; lo que entrenas es pequeño, barato y fácil de inspeccionar.
El cuarto nivel ajusta los pesos, y para eso hacen falta pesos abiertos o un proveedor que ofrezca el servicio. Cloudflare publicó Clef con licencia Apache 2.0 y anunció un servicio de ajuste fino (fine-tuning) basado en aprendizaje por refuerzo, en el que el modelo se ajusta según recompensas por sus respuestas. Por ahora lo prestan sus propios ingenieros junto a cada cliente, con una versión de autoservicio prevista, y usa datos de solicitudes capturados a través del AI Gateway de Cloudflare (Chen et al., 2026 (se abre en una pestaña nueva)). Laya publica un cuaderno que ajusta su modelo en unas cuatro horas con dos GPU NVIDIA T4 en Kaggle, una plataforma de ciencia de datos que ofrece tiempo de GPU gratuito. Su desarrollador señala además que los mejores resultados en su propio benchmark llegan después de ajustar el modelo con los datos de entrenamiento de ese benchmark, no del modelo base (ConvAI Innovations, s. f. (se abre en una pestaña nueva)).
¿De dónde salen las etiquetas? La tienda ya las produce: cada caso enviado a una persona termina en una decisión humana. Pero esos casos no son una muestra al azar. Son los que el modelo puntuó con 50 % o menos, así que un modelo ajustado solo con ellos aprende de la zona de baja probabilidad de cobertura y nunca ve si sus respuestas confiadas acertaron. Un buen conjunto de entrenamiento y evaluación incluye también una porción aleatoria de las decisiones automáticas, revisadas después.
Los costos pueden entrar en el entrenamiento al cambiar la proporción de ejemplos de cada clase, lo que vincula ese entrenamiento con una relación de costos concreta. Charles Elkan deriva esa opción de rebalanceo, pero recomienda otro camino para los clasificadores que examina: entrenar con los datos tal como están y después usar las probabilidades estimadas para elegir la acción de menor costo esperado. Su ecuación 2 da el umbral binario óptimo a partir de la matriz de costos; también recomienda ajustarlo empíricamente cuando haga falta (Elkan, 2001 (se abre en una pestaña nueva)). Esa separación es la que nos permite sustituir la taza por un jarrón y cambiar los umbrales sin reentrenar. Después de cualquier ajuste fino, vuelve a medir la calibración con casos que el modelo no haya visto, porque los umbrales dependen de esas probabilidades.
Dónde encaja y dónde no
Un modelo de decisión encaja cuando la pregunta es un juicio que una persona entendida podría hacer en pocos segundos y las respuestas posibles se pueden enumerar: qué equipo debe atender un ticket, si es seguro ejecutar un comando, si un pasaje respalda una afirmación. Encaja mal cuando la respuesta debe calcularse, como en la aritmética, el conteo o la comparación de fechas, que la propia TypeSafe recomienda dejar en el código, y cuando la salida debe redactarse, como una explicación, un resumen o una respuesta (TypeSafe AI, s. f.-b (se abre en una pestaña nueva)).
De lo que hemos visto se siguen tres consecuencias prácticas. Primero, mide con tus propios casos antes de confiar en las cifras de un proveedor. Las comparaciones destacadas de TypeSafe provienen de evaluaciones diseñadas por su propio equipo, lo que la empresa reconoce que puede introducir sesgos, y las tablas de benchmarks de Cloudflare también son propias (Almeida, 2026 (se abre en una pestaña nueva); Chen et al., 2026 (se abre en una pestaña nueva)). Para la tienda, un primer paso práctico es el modo sombra (shadow mode): mantener el proceso actual a cargo y registrar qué habrían recomendado el modelo y la regla de costos, sin emitir reembolsos ni contactar a clientes desde esa prueba. Compara esas recomendaciones con los reclamos resueltos antes de habilitar acciones automáticas.
Segundo, registra lo que produjo cada decisión: el estado, la versión del modelo, las versiones de las preguntas y de la política, las probabilidades, los umbrales y la acción. Cambiar una instrucción o la descripción de una opción puede cambiar el comportamiento aunque el modelo siga siendo el mismo. Ese registro permite que un auditor reconstruya la regla de la aplicación; no revela el razonamiento interno del modelo ni prueba que la decisión estuviera justificada. TypeSafe recomienda fijar una versión concreta una vez ajustados los umbrales, porque un alias puede cambiar el modelo que hay debajo (TypeSafe AI, s. f.-c (se abre en una pestaña nueva)).
Tercero, ten un cuidado especial cuando la decisión concierne a una persona. Un solo número puede cargar sesgos aprendidos de los datos sin dejar rastro en ninguna regla, por lo que comparar los errores entre los grupos afectados es una parte necesaria de la evaluación, junto con examinar los datos y la propia política.
De vuelta a la taza rota
Ahora podemos explicar las tres respuestas. El mismo modelo de decisión leyó tres mensajes y devolvió tres probabilidades, digamos 0.99, 0.90 y 0.30. La decisión no ocurrió dentro del modelo. Ocurrió en una regla que comparaba costos esperados: un reembolso inmediato cuando un error era muy improbable, una foto cuando una comprobación barata compensaba su fricción, y una persona cuando el caso era demasiado incierto para automatizarlo.
Entonces, ¿qué es un modelo de decisión? En los productos de IA que vimos aquí, un modelo que convierte información no estructurada en probabilidades sobre respuestas que tú definiste. En el sentido más antiguo y amplio, la descripción completa de una elección, incluidos los costos que alguien, no el modelo, decidió aceptar. El primero vuelve el segundo lo bastante barato para aplicarlo a cada mensaje. No lo vuelve innecesario.
Notas
- La confianza tampoco es la decisión. Para las respuestas Choice y Score, TypeSafe devuelve además un valor
confidencederivado de las probabilidades. Para una Choice con opciones es : vale 1 cuando toda la probabilidad cae en una opción y 0 cuando se reparte por igual (TypeSafe AI, s. f.-a (se abre en una pestaña nueva)). Para las puntuaciones inventadas del ejemplo de softmax, la probabilidad máxima es 0.786 y la confianza, alrededor de 0.68. Ambas son entradas de la decisión; ninguna es la decisión. Volver a la explicación - Por qué solo gana la probabilidad verdadera. Si el evento ocurre con probabilidad y declaramos , la puntuación de Brier esperada es . Su derivada, , solo se anula en , y la segunda derivada, 2, es positiva, de modo que ese punto es el único mínimo. Con : y . Volver a la explicación
- De dónde salen los umbrales. Reembolsar supera a la foto cuando , es decir, , o . La foto supera a la persona cuando , es decir, . Sin la foto, reembolsar supera a la persona cuando , es decir, , o . En la igualdad hay empate de costos. Lo asignamos a persona en , a foto en y a persona en cuando no hay foto. Costos reales y otras tasas de error darían límites distintos. Volver a la explicación
- Un árbol de decisión es otra cosa. En aprendizaje automático, un árbol de decisión es un modelo predictivo que divide los datos con preguntas sucesivas. En análisis de decisiones, un árbol de decisión es un diagrama de elecciones y eventos aleatorios que se evalúa por valor esperado, cercano a los diagramas de influencia de arriba. El nombre compartido esconde dos objetos distintos. Volver a la explicación
Referencias
Almeida, D. (2026, 15 de septiembre). Introducing System One models & Jev. TypeSafe AI Blog. Fuente original (se abre en una pestaña nueva)
Chang, M.-W., Ratinov, L.-A., Roth, D., & Srikumar, V. (2008). Importance of semantic representation: Dataless classification. En Proceedings of the Twenty-Third AAAI Conference on Artificial Intelligence (pp. 830–835). AAAI Press. Registro de las actas (se abre en una pestaña nueva)
Chen, M., Reneau, A., & Flansburg, K. (2026, 1 de octubre). Introducing Clef: Our open-source decision models, and new RL fine-tuning platform. The Cloudflare Blog. Fuente original (se abre en una pestaña nueva)
ConvAI Innovations. (s. f.). Laya [Página del proyecto]. Recuperado el 11 de octubre de 2026, de Fuente original (se abre en una pestaña nueva)
Elkan, C. (2001). The foundations of cost-sensitive learning. En B. Nebel (Ed.), Proceedings of the Seventeenth International Joint Conference on Artificial Intelligence (pp. 973–978). Morgan Kaufmann. Registro de las actas (se abre en una pestaña nueva)
Gneiting, T., & Raftery, A. E. (2007). Strictly proper scoring rules, prediction, and estimation. Journal of the American Statistical Association, 102(477), 359–378. DOI (se abre en una pestaña nueva)
Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017). On calibration of modern neural networks. En D. Precup & Y. W. Teh (Eds.), Proceedings of the 34th International Conference on Machine Learning (Vol. 70, pp. 1321–1330). PMLR. Actas (se abre en una pestaña nueva)
Howard, R. A. (1983). Decision analysis: Applied decision theory. En R. A. Howard & J. E. Matheson (Eds.), Readings on the principles and applications of decision analysis (Vol. 1, pp. 95–113). Strategic Decisions Group. (Obra original publicada en 1966) Registro bibliográfico (se abre en una pestaña nueva)
Howard, R. A., & Matheson, J. E. (2005). Influence diagrams. Decision Analysis, 2(3), 127–143. DOI (se abre en una pestaña nueva) (Obra original publicada en 1984)
Kahneman, D. (2011). Thinking, fast and slow. Farrar, Straus and Giroux. Libro (se abre en una pestaña nueva)
Object Management Group. (2026). Decision Model and Notation (DMN) (Versión 1.6). Especificación (se abre en una pestaña nueva)
OpenAI. (2026, 29 de septiembre). DevDay 2026 recap. Anuncio (se abre en una pestaña nueva)
TypeSafe AI. (s. f.-a). Confidence. TypeSafe documentation. Recuperado el 11 de octubre de 2026, de Fuente original (se abre en una pestaña nueva)
TypeSafe AI. (s. f.-b). Jev 1.13 jaggedness. TypeSafe documentation. Recuperado el 11 de octubre de 2026, de Fuente original (se abre en una pestaña nueva)
TypeSafe AI. (s. f.-c). Models. TypeSafe documentation. Recuperado el 11 de octubre de 2026, de Fuente original (se abre en una pestaña nueva)
Yin, W., Hay, J., & Roth, D. (2019). Benchmarking zero-shot text classification: Datasets, evaluation and entailment approach. En K. Inui, J. Jiang, V. Ng, & X. Wan (Eds.), Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing and the 9th International Joint Conference on Natural Language Processing (EMNLP-IJCNLP) (pp. 3914–3923). Association for Computational Linguistics. DOI (se abre en una pestaña nueva)
Personas mencionadas
Daniel Kahneman
Psicólogo y premio Nobel de Economía de 2002. Reconocido por integrar la investigación psicológica en la economía, especialmente el estudio de los juicios y las decisiones bajo incertidumbre.
Fuentes
Ronald A. Howard
Ingeniero y profesor de Stanford que contribuyó a establecer el análisis de decisiones como disciplina. Su trabajo desarrolló formas sistemáticas de representar incertidumbre, preferencias y alternativas en elecciones importantes.
Fuentes
Charles Elkan
Científico de la computación cuya investigación incluye aprendizaje automático y minería de datos. Su trabajo sobre aprendizaje sensible a los costos explica cómo distintos costos de error afectan las decisiones de clasificación.
Fuentes