IA explicada
¿Qué es una red neuronal?
De un dígito escrito a mano a una predicción: cómo funcionan las neuronas y las capas, cómo aprende una red y qué lugar ocupan sus arquitecturas en la inteligencia artificial.
Escribe un 3 en una hoja. Ahora escribe otro, un poco inclinado, y un tercero con el trazo superior casi cerrado. Para ti siguen siendo tres. Si tuvieras que explicarle a una computadora cómo reconocerlos, ¿qué reglas escribirías? «Busca dos curvas» parece un buen comienzo, hasta que aparece una letra con dos curvas o un 8 mal cerrado. Lo que reconocemos con facilidad puede ser difícil de convertir en instrucciones precisas.
Del trazo a los píxeles: una ilustración conceptual inspirada en los dígitos manuscritos de MNIST.
Una red neuronal artificial es un modelo matemático que conecta unidades de cálculo para transformar una entrada en una salida. Sus conexiones tienen parámetros ajustables: al entrenarla con datos y un objetivo, podemos modificar esos parámetros para que produzca respuestas más útiles. En nuestro ejemplo, la entrada será una imagen y la salida, una estimación de qué dígito contiene. La red aprenderá una forma de hacer esa transformación, incluidas representaciones intermedias de la imagen (Goodfellow et al., 2016, cap. 6 (se abre en una pestaña nueva)).
En ¿La IA es realmente nueva? recorrimos algunas ideas que hicieron posible aprender con máquinas. Aquí vamos a abrir una de ellas por dentro. Podemos seguir el viaje de ese 3 desde los píxeles hasta la respuesta y, cuando la respuesta falle, ver qué significa corregir la red.
Qué hay dentro de una neurona artificial
Para reconocer nuestro 3, la computadora recibirá números que describen la imagen. Antes de pensar en toda la red, imaginemos una unidad que recibe apenas dos de esos números. Una neurona artificial combina las entradas y entrega un resultado a otras unidades. El nombre conserva la inspiración biológica de recibir y transmitir señales; aquí podemos seguir cada paso como una operación matemática.
La primera decisión es cuánto aporta cada entrada. Para eso sirve un peso: un número que multiplica el valor que llega por una conexión. Podemos imaginar un control de volumen para cada entrada, con una diferencia importante: un peso negativo hace que su contribución reste. Si una entrada vale 0.8 y su peso es 0.5, aporta 0.4 a la suma. Si el peso fuera 0.1, esa misma entrada aportaría 0.08. La imagen sería idéntica; lo que cambiaría es cómo esa unidad la procesa.
La neurona suma esas contribuciones y añade un sesgo, otro número ajustable que desplaza el total. Después necesita una regla que determine qué valor pasará a la siguiente etapa. Esa regla es la función de activación: recibe la suma y la transforma. El valor que devuelve se llama activación de la neurona.
Una opción habitual es ReLU, abreviatura de rectified linear unit, o unidad lineal rectificada. Su regla es sencilla: si la suma es cero o negativa, entrega 0; si es positiva, entrega esa misma cantidad. Una suma de −0.2 queda en 0; una de 0.42 pasa como 0.42. Se parece a una compuerta que bloquea los valores de un lado del cero y deja pasar los del otro, conservando su intensidad. Por eso puede transmitir cuánto se activó una unidad, en lugar de limitarla a «encendida» o «apagada» (Zhang et al., 2023, sec. 5.1.2 (se abre en una pestaña nueva)).
¿Para qué introducir ese paso? Pensemos en dos zonas oscuras de nuestro dibujo: su utilidad depende de cómo aparezcan juntas. Los pesos y el sesgo permiten que una combinación de entradas produzca una suma positiva y otra quede en cero o por debajo; ReLU transmite una respuesta en el primer caso y cero en el segundo. Al combinar muchas unidades así, la red puede responder de manera diferente a distintas combinaciones de píxeles. La regla de ReLU es fija en este ejemplo; durante el entrenamiento cambian los pesos y sesgos que determinan qué entradas la activan.
Ahora la fórmula puede resumir algo que ya conocemos. Con entradas y , pesos y , sesgo y activación :
La primera línea calcula la suma ; la segunda obtiene la respuesta que recibirán otras unidades. Para ReLU, : elegir el mayor entre cero y la suma. El sesgo también tiene un efecto práctico: al desplazar , cambia qué combinaciones de entradas consiguen superar el cero. Pesos y sesgos son parámetros, los números ajustables del modelo.
Hagamos una cuenta con valores elegidos para ilustrarlo. Si las entradas son 0.8 y 0.2, los pesos son 0.5 y −0.4, y el sesgo es 0.1:
Si cambiamos solo el primer peso de 0.5 a 0.7, la respuesta pasa de 0.42 a 0.58. Las mismas entradas producen ahora una señal más intensa para la siguiente unidad. Ese es el efecto concreto de ajustar un peso; saber si el cambio ayuda a reconocer el 3 requerirá mirar la respuesta final de la red. Primero necesitamos conectar esta pequeña operación con las demás.
De los píxeles a una representación
Nuestro 3 ocupa muchos puntos de la imagen, así que ampliemos el ejemplo. Preparemos una imagen en escala de grises de píxeles: una cuadrícula de 784 posiciones. En cada posición escribimos un número entre 0 y 1; para este ejemplo, 0 representa el fondo blanco y 1 la tinta negra, con valores intermedios para los grises. Así convertimos el dibujo en 784 números que la red puede procesar. Esos números forman la entrada.
Diseñemos una red sencilla con una capa de 64 neuronas y una salida de diez valores, uno para cada dígito del 0 al 9. Cada neurona de esa capa recibe los 784 valores, con sus propios pesos y su sesgo. Sus 64 respuestas pasan a las unidades de salida. Elegimos 64 para concretar la arquitectura. El tamaño adecuado para un modelo real dependería de la tarea y de la evaluación experimental.
¿Dónde están definidos los pesos? Al construir estas capas, el programa crea tablas de números —matrices— con un peso por conexión y un sesgo por neurona. Quien diseña la red elige las conexiones y cómo inicializar esos números; al entrenar desde cero, los pesos suelen comenzar con valores aleatorios de una escala apropiada. Después, el algoritmo de entrenamiento los ajusta. No tenemos que escribir a mano el peso correcto para cada trazo. El mismo conjunto de pesos se usa para todas las imágenes que atraviesan la red; esa posibilidad de reutilizar un ajuste es lo que queremos aprovechar (Goodfellow et al., 2016, sec. 8.4 (se abre en una pestaña nueva); Zhang et al., 2023, sec. 6.2 (se abre en una pestaña nueva)).
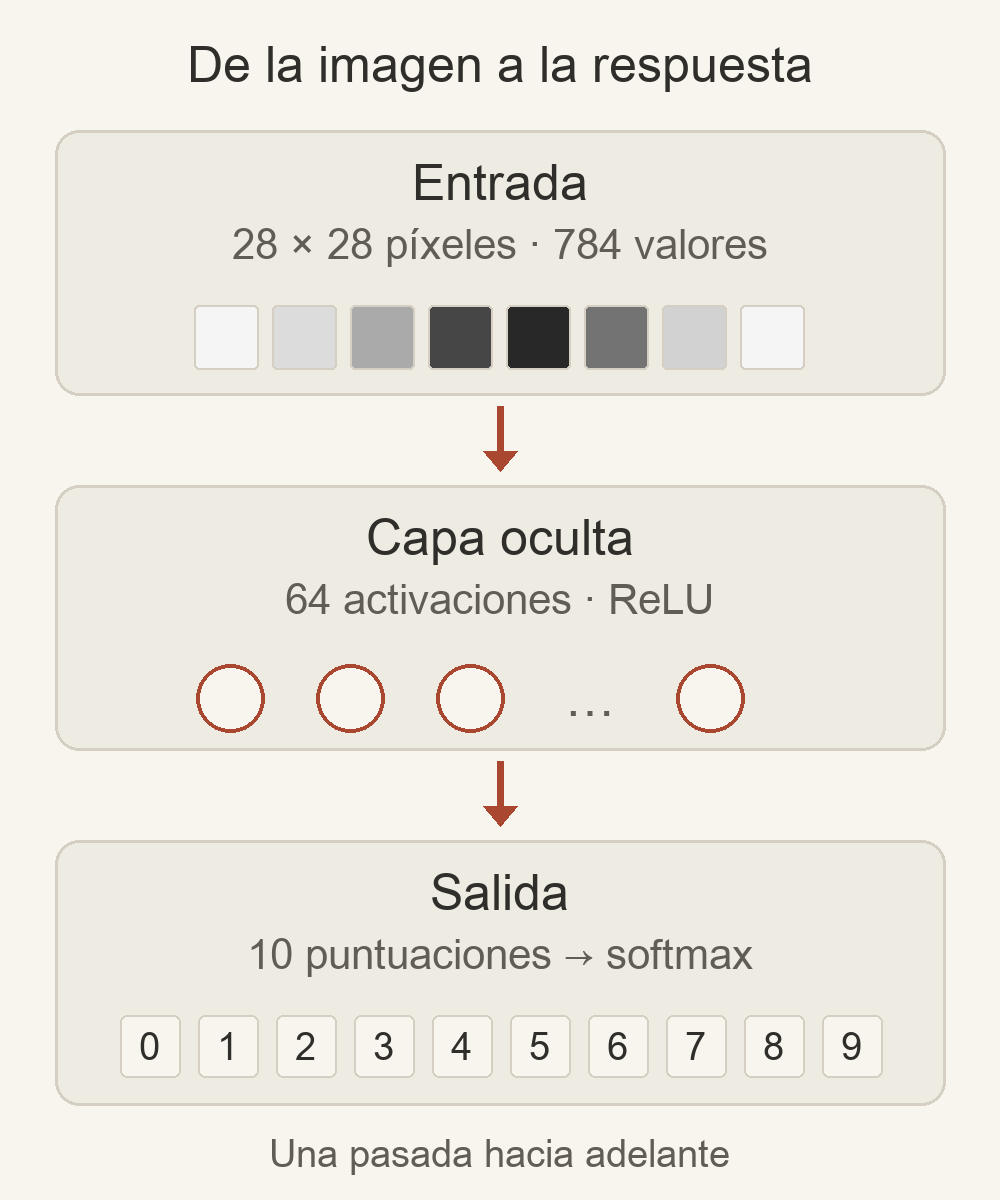
Una red posible para nuestro ejemplo. Cada bloque representa una etapa de cálculo; se omiten las conexiones individuales. Los tamaños describen un diseño ilustrativo.
La capa intermedia se llama oculta porque está entre la entrada y la respuesta final; sus valores se pueden calcular e inspeccionar. Pensemos en lo que acaba de ocurrir: pasamos de describir dónde hay tinta con 784 números a describir las respuestas de 64 unidades. Esa nueva lista es una representación de la imagen. Si sus respuestas distinguen combinaciones de trazos útiles, la etapa siguiente tendrá una mejor base para separar un 3 de un 8. El entrenamiento ajusta cómo se construye esa representación a partir de la respuesta final, sin necesitar una etiqueta correcta para cada neurona oculta (Rumelhart et al., 1986 (se abre en una pestaña nueva)).
Es tentador imaginar una neurona que detecta «curva superior» y otra que detecta «curva inferior». Puede ayudar a visualizar la idea, pero no es una descripción garantizada de lo que aprenderá nuestra red. Una característica puede depender de muchas unidades, y una misma unidad puede participar en varias distinciones.
Podemos añadir más capas para volver a combinar esas respuestas. Esa composición es central en el aprendizaje profundo. Aquí se ve por qué importaba la activación: si cada etapa solo multiplicara y sumara, toda la cadena se podría resumir en una única operación del mismo tipo, una transformación afín. ReLU introduce un cambio de comportamiento al cruzar cero: distintas entradas activan distintos conjuntos de unidades. Esa no linealidad permite que las capas construyan relaciones más complejas, en lugar de limitarse a recalcular una suma más larga (Goodfellow et al., 2016, secs. 6.1–6.4 (se abre en una pestaña nueva)). Ya tenemos una estructura capaz de transformar el dibujo; ahora sigamos una imagen hasta su respuesta.
El recorrido hacia adelante: obtener una respuesta
Demos a la red la imagen de nuestro 3. Primero calcula las 64 activaciones ocultas con los pesos que tiene en ese momento. Después, a partir de ellas, calcula diez puntuaciones de salida: una para el 0, otra para el 1, y así hasta el 9. Cada puntuación resulta de combinar las respuestas de la capa anterior con otro conjunto de pesos. Este recorrido es la propagación hacia adelante, o forward pass. Como las conexiones avanzan desde la entrada hasta la salida sin formar ciclos, llamamos a esta arquitectura una red feedforward.
Las puntuaciones finales, también llamadas logits, nos permiten ordenar las opciones. Si la del 8 es la mayor, esa será la clase elegida por nuestra regla de decisión, aunque nosotros veamos un 3. Pero «8 es la opción con mayor puntuación» deja abierta una cuestión útil: ¿está muy por delante de las demás o casi empatada con el 3?
Para expresar cómo se reparte la predicción entre las opciones, usamos softmax. Esta función transforma las diez puntuaciones en probabilidades positivas que suman 1. Podemos imaginar un total del 100 % repartido entre diez casillas: las puntuaciones mayores reciben una porción mayor. La fórmula usa exponenciales para obtener valores positivos y divide cada uno entre la suma de todos; así conserva el orden y pone las salidas en una escala común (Zhang et al., 2023, sec. 4.1 (se abre en una pestaña nueva)).
Softmax encaja aquí porque cada imagen tiene una sola etiqueta correcta entre diez alternativas. Si solo quisiéramos elegir la puntuación más alta, podríamos hacerlo directamente. La distribución añade algo que usaremos al aprender: permite distinguir una predicción que asigna poca probabilidad al 3 de otra que le asigna mucha, incluso si ambas eligen la misma clase. Además, cambia suavemente cuando cambian las puntuaciones, lo que nos permitirá calcular cómo ajustar los pesos. La nota 1 reúne la fórmula y la notación de la red completa.
Por ejemplo, 0.8 para el dígito 3 significa que el modelo le asigna el 80 % de la probabilidad entre esas opciones. Para saber si acierta el 80 % de las veces en situaciones similares hay que comprobarlo con datos: esa correspondencia se llama calibración (Guo et al., 2017 (se abre en una pestaña nueva)). Y si mostramos una letra, softmax seguirá repartiendo la probabilidad entre dígitos, porque esas son las únicas opciones que diseñamos. La distribución describe la salida del modelo dentro de esa tarea.
Ya tenemos una respuesta, pero todavía usamos los mismos pesos con los que empezamos. Aprender será modificar esos parámetros a partir de ejemplos y un criterio de error, buscando respuestas más útiles. Si repitiéramos este recorrido con la misma imagen y los mismos parámetros en nuestra red, obtendríamos lo mismo. Para avanzar necesitamos algo que el cálculo por sí solo no aporta: una manera de evaluar la respuesta.
Ponerle una medida al error
Para nuestro 3, nosotros conocemos la respuesta correcta. Durante el entrenamiento se la proporcionamos al sistema junto con la imagen; hacemos lo mismo con ejemplos de los demás dígitos. Eso se llama aprendizaje supervisado. La etiqueta funciona como la respuesta de un ejercicio: permite corregir el intento. Cuando después mostremos una imagen nueva para reconocerla, el modelo tendrá que responder usando los parámetros aprendidos.
Pero corregir solo con «acertó» o «falló» sería una señal muy limitada. Si la red aumenta la probabilidad del 3 de 0.2 a 0.3 y todavía elige 8, ha avanzado en una dirección útil para ese ejemplo aunque siga fallando. Una función de pérdida convierte la diferencia entre la predicción y el objetivo en un número que puede reflejar ese avance. Para nuestro clasificador usamos la entropía cruzada: cuando la etiqueta correcta es 3, da una pérdida mayor si el modelo le asigna poca probabilidad y menor si le asigna mucha. Se escribe así:
Aquí es la probabilidad asignada al dígito correcto y usamos el logaritmo natural. Si , la pérdida es aproximadamente 1.61; si , es aproximadamente 0.22. La regla recompensa asignar más probabilidad a la respuesta correcta, incluso cuando la clase ganadora ya era la adecuada. Contar aciertos y medir la pérdida son dos formas distintas de evaluar el comportamiento (Zhang et al., 2023, sec. 4.1 (se abre en una pestaña nueva)).
Normalmente agrupamos varios ejemplos en un lote y calculamos una pérdida promedio para orientar un ajuste. La pregunta deja de ser solamente «¿se equivocó?» y pasa a ser «¿cómo tendrían que cambiar sus parámetros para reducir esta pérdida?».
La señal de aprendizaje depende de la tarea. En el aprendizaje autosupervisado, por ejemplo, el objetivo puede construirse a partir de los propios datos, como ocultar una parte y pedir al modelo que la prediga. Seguimos necesitando una tarea y una pérdida; no hace falta que una persona escriba una etiqueta para cada ejemplo. Predecir fragmentos ocultos del texto es un ejemplo de ese enfoque (Zhang et al., 2023, sec. 15.8 (se abre en una pestaña nueva)). Esta distinción será importante cuando pasemos de las imágenes al lenguaje.
Volvamos a nuestro dígito: la etiqueta nos da un objetivo, softmax nos da una distribución y la pérdida mide qué tan lejos queda la predicción de ese objetivo según el criterio elegido. Falta conectar ese número final con cada peso que podemos ajustar.
Retropropagación: conectar el error con los parámetros
Recordemos el peso que cambiamos de 0.5 a 0.7: aumentó la respuesta de una neurona de 0.42 a 0.58. Ahora la pregunta es si ese aumento ayuda a reconocer el 3 o refuerza una respuesta equivocada. Depende de lo que hagan las unidades posteriores con esa señal. La pérdida está al final del recorrido, pero ese peso influyó mucho antes: cambió una activación, que modificó las puntuaciones, que alteraron las probabilidades. Necesitamos seguir esa cadena de dependencias.
La retropropagación, o backpropagation, calcula cuánto varía localmente la pérdida respecto de cada parámetro. Lo hace recorriendo las operaciones en sentido inverso y aplicando la regla de la cadena, que combina las derivadas de operaciones conectadas. Reutiliza resultados intermedios, de modo que no necesita probar cada peso por separado para estimar su efecto (Zhang et al., 2023, sec. 5.3 (se abre en una pestaña nueva)).
En términos prácticos, queremos saber: «Si moviera este control de volumen un poquito hacia arriba, ¿la pérdida subiría o bajaría? ¿Cuánto?». Una derivada expresa esa sensibilidad local, y el conjunto de derivadas respecto de los parámetros forma el gradiente. La retropropagación calcula esas respuestas de manera eficiente siguiendo las operaciones de la red. La nota 2 recorre un ejemplo numérico completo.
Después interviene un optimizador, que utiliza esos gradientes para cambiar los parámetros. Una actualización sencilla de descenso por gradiente es:
La flecha significa «reemplaza el valor anterior». El símbolo es la tasa de aprendizaje, que controla el tamaño del paso. Si la derivada es positiva, la regla disminuye el peso; si es negativa, lo aumenta. La retropropagación calcula el gradiente y el optimizador decide el ajuste. Son partes distintas del proceso.
La tasa de aprendizaje indica cuánto movemos cada control después de recibir esa orientación. Un paso muy pequeño puede hacer lento el avance; uno muy grande puede pasarse y empeorar la pérdida. Para nuestra imagen, el ajuste cambia cómo contribuyen los píxeles a las respuestas ocultas y cómo contribuyen esas respuestas a las diez puntuaciones. Un recorrido posterior puede entonces asignar otra probabilidad al 3, aunque la imagen siga siendo la misma.
Con los nuevos parámetros, repetimos el recorrido hacia adelante sobre otro lote. Una época es un recorrido completo por el conjunto de entrenamiento. Predecir, medir la pérdida, calcular gradientes y actualizar: ese ciclo da un significado concreto a «la red aprende». El tamaño de los pasos y la forma del problema condicionan esa búsqueda: una actualización puede ayudar a algunos ejemplos y perjudicar a otros, y el entrenamiento puede llegar a una solución que no sea la mejor posible (Goodfellow et al., 2016, cap. 8 (se abre en una pestaña nueva)).
Esto también explica una dificultad de apilar muchas capas. La retropropagación combina factores de sensibilidad a lo largo del recorrido. Esos productos pueden volverse muy pequeños, dejando algunos pesos con un ajuste casi nulo, o muy grandes, haciendo inestables las actualizaciones. Son el desvanecimiento y la explosión del gradiente, dificultades de la optimización, la búsqueda de parámetros que reduzcan la pérdida. La inicialización y el diseño de la red ayudan a aprovechar la profundidad (Goodfellow et al., 2016, secs. 8.2.4–8.2.5 y 8.4 (se abre en una pestaña nueva)).
Ya podemos decir qué significa aprender en este modelo: los ejemplos orientan cambios en números que volveremos a usar ante nuevas entradas. Podemos guardar esos parámetros y cargarlos para ejecutar la red de nuevo (Zhang et al., 2023, sec. 6.2 (se abre en una pestaña nueva)). La pregunta práctica pasa a ser si esos ajustes también ayudarán con un 3 escrito por otra persona.
Reconocer un tres que nunca había visto
Probemos ese otro 3. Si todos los ejemplos de entrenamiento venían de la misma libreta, quizá la red haya aprovechado detalles del fondo que desaparecen en la hoja nueva. Puede haber reducido la pérdida y, aun así, fallar ahora. Es la diferencia práctica entre mejorar con los ejercicios conocidos y poder resolver uno que no habíamos mostrado.
Queremos generalización: que el comportamiento útil se mantenga en ejemplos no usados para entrenar. Reservamos datos de validación para orientar decisiones, como cuándo detener el entrenamiento, y un conjunto de prueba para evaluar el resultado final. Si usáramos continuamente la prueba para elegir cambios, dejaría de ser una evaluación independiente. El sobreajuste aparece cuando el modelo se adapta demasiado a los ejemplos de entrenamiento y responde peor a otros (Goodfellow et al., 2016, sec. 5.2 (se abre en una pestaña nueva)).
Una vez entrenada, podemos darle otro 3 y ejecutar la inferencia: usar los parámetros aprendidos para obtener una respuesta. Las activaciones cambiarán con cada imagen, mientras que los pesos permanecerán fijos en este uso habitual. Para este clasificador, eso significa usar el recorrido hacia adelante para reconocer la imagen nueva.
Eso permite distinguir dos cosas que a veces mezclamos al hablar de aprendizaje: una respuesta diferente ante una entrada diferente y un cambio duradero en los parámetros. Si más adelante queremos adaptar el modelo con nuevos datos, hará falta otro proceso de entrenamiento. Y si esos datos vienen de condiciones distintas, habrá que comprobar de nuevo cómo responde.
Distintas redes para distintas estructuras
Supongamos que el nuevo 3 también está desplazado hacia un lado de la imagen. Seguimos reconociendo su forma, pero la tinta ocupa ahora otras posiciones de entrada. Eso nos da una razón para revisar cómo organizamos las conexiones. Nuestro ejemplo conecta cada entrada con cada neurona de la siguiente capa. Es una red de capas densas, también llamada perceptrón multicapa o MLP. Sirve para entender el mecanismo, pero al aplanar la imagen en una lista no incorporamos explícitamente que ciertos píxeles son vecinos. La arquitectura decide qué se conecta, qué operaciones se realizan y qué parámetros se comparten. Podemos elegir diseños que aprovechen mejor la estructura del problema.
Las redes convolucionales, o CNN, aplican filtros aprendidos sobre regiones locales y reutilizan sus pesos en distintas posiciones. Así, un filtro que responde a cierto trazo puede aplicarse en diferentes zonas de la imagen. Varias capas combinan información de regiones cada vez mayores. Para nuestro dígito, esto incorpora una idea útil: un trazo sigue siendo relevante aunque se desplace un poco. Esto introduce estructura espacial en el modelo; qué tan bien responde a los desplazamientos sigue dependiendo de la arquitectura completa y del entrenamiento (Zhang et al., 2023, sec. 7.1 (se abre en una pestaña nueva)).
La estructura de la entrada puede cambiar de otra manera. Imaginemos que registramos los movimientos del lápiz mientras alguien dibuja el 3: ahora recibimos una secuencia cuyo orden importa. Las redes recurrentes, o RNN, procesan secuencias manteniendo un estado que se actualiza en cada paso. Al recibir un nuevo elemento, usan tanto ese elemento como información del estado anterior. LSTM es una variante con mecanismos que regulan el paso y la conservación de información, diseñada para facilitar el aprendizaje de dependencias lejanas. Lo que permanece en ese estado depende de las actualizaciones y de las compuertas aprendidas (Hochreiter & Schmidhuber, 1997 (se abre en una pestaña nueva)).
Para trabajar con secuencias también podemos diseñar un mecanismo que combine directamente información de otras posiciones. Los Transformers combinan mecanismos de atención, que ponderan información de distintas posiciones, con bloques de redes feedforward y otras operaciones. La atención permite que una representación incorpore contexto de otras partes de la entrada. En una variante causal, las posiciones no pueden consultar elementos futuros. Aquí basta reconocer la idea: el modo de relacionar la información también forma parte del diseño de la red (Vaswani et al., 2017 (se abre en una pestaña nueva)).
Estas familias ilustran distintas decisiones sobre conexiones y cómputo, y esas decisiones pueden coexistir en un mismo modelo. Una CNN puede ser feedforward; un Transformer contiene bloques feedforward. Su utilidad depende de la tarea y de la estructura de los datos.
Cómo pueden trabajar juntas
Imaginemos ahora una foto con varios dígitos. Podríamos diseñar un sistema donde un componente localice cada símbolo y otro reconozca los recortes. También podríamos construir una red que transforme la imagen completa en una secuencia de dígitos. Son dos maneras posibles de repartir el trabajo; exigen entrenamientos e interfaces entre componentes diferentes.
Una combinación habitual es codificador–decodificador: una red transforma la entrada en una representación y otra utiliza esa representación para producir la salida. Cho y sus colegas estudiaron ese esquema con redes recurrentes para relacionar secuencias de palabras en traducción (Cho et al., 2014 (se abre en una pestaña nueva)). «Codificador» y «decodificador» nombran funciones dentro del sistema; distintas arquitecturas pueden desempeñarlas.
Cuando los componentes se entrenan juntos y el recorrido permite propagar gradientes, una pérdida final puede orientar ajustes a través de todos ellos. Si los entrenamos por separado o mantenemos alguno fijo, la adaptación será diferente. También podemos combinar las predicciones de varias redes mediante un ensamblado, sin convertirlas por ello en una única red entrenada de extremo a extremo.
Por eso, al decir que las redes «interactúan», conviene mirar qué se intercambian: activaciones, representaciones, probabilidades o resultados que otro programa convierte en entradas. La conexión la define el sistema que construimos: la salida de un cálculo se convierte en material para el siguiente.
Qué aporta esta idea a la inteligencia artificial
Volvamos al 3 de la hoja. Al principio parecía que necesitábamos una regla para cada variación de la escritura. Una red neuronal nos ofrece otra posibilidad: diseñar un proceso de cálculo cuyos parámetros y representaciones puedan ajustarse a partir de ejemplos. Seguimos eligiendo datos, arquitectura, objetivos y criterios de evaluación, pero una parte importante de cómo transformar la entrada se aprende durante el entrenamiento.
Ese es uno de sus aportes a la IA: aprender representaciones útiles para reconocer, predecir o generar, en tareas donde describir manualmente cada patrón resulta difícil. El mismo marco general admite salidas diferentes: una categoría, una cantidad o una distribución con la que generar elementos de una secuencia. La IA también incluye otros métodos, y una red neuronal puede ser solo un componente de una aplicación.
Un modelo de lenguaje lleva el problema hacia secuencias de texto. Para llegar a un LLM, o gran modelo de lenguaje, tendremos que explorar cómo representar ese texto, cómo relacionar sus partes y con qué objetivos y escala entrenar. El Transformer es una arquitectura que puede utilizarse en ese camino; no todo Transformer es un LLM ni toda red neuronal trabaja con lenguaje.
Un sistema agéntico añade otra organización: utiliza un modelo dentro de un ciclo que puede elegir acciones, consultar herramientas y procesar sus resultados. Trabajos como ReAct estudian cómo entrelazar la generación del modelo con acciones sobre un entorno (Yao et al., 2023 (se abre en una pestaña nueva)). Para entender ese sistema habrá que mirar tanto la red como el programa que la pone a actuar.
Nuestro 3 sigue siendo un 3, pero ya podemos describir lo que ocurre al mostrarlo a la máquina. Los píxeles se convierten en activaciones, las activaciones en una predicción y, durante el entrenamiento, la pérdida orienta cambios en los parámetros. Esa distinción entre representar, calcular y aprender nos permitirá avanzar hacia sistemas más complejos sin perder de vista qué hace cada pieza.
Notas
-
La red en notación compacta. Podemos escribir la capa oculta como y las puntuaciones de salida como . Las letras en negrita representan listas de números o vectores; las matrices y reúnen los pesos. En nuestro diseño tienen tamaños y . Para cada dígito , softmax calcula . Los exponenciales son positivos y dividirlos entre su suma hace que las probabilidades sumen 1. La fórmula describe el resultado matemático; las implementaciones usan una versión numéricamente estable. Véase Zhang et al. (2023, sec. 4.1) (se abre en una pestaña nueva). Volver al recorrido hacia adelante.
-
Una actualización que podemos comprobar. Aislemos un modelo escalar con pérdida . Es un ejemplo aritmético, no nuestro clasificador de dígitos. La regla de la cadena da . Con , y , la predicción es 0.4, la pérdida es 0.18 y el gradiente es −1.2. Si , el nuevo peso es . La nueva predicción es 0.64 y la pérdida baja a 0.0648. En una red, la misma regla se aplica a cadenas más largas y suma las contribuciones cuando hay varios caminos. El tamaño del paso importa: una tasa de aprendizaje demasiado grande puede aumentar la pérdida. ReLU tampoco tiene derivada única en cero; en ese punto las implementaciones usan una convención. Volver a la retropropagación.
Referencias
Cho, K., van Merriënboer, B., Gulcehre, C., Bahdanau, D., Bougares, F., Schwenk, H., & Bengio, Y. (2014). Learning phrase representations using RNN encoder–decoder for statistical machine translation. En A. Moschitti, B. Pang, & W. Daelemans (Eds.), Proceedings of the 2014 Conference on Empirical Methods in Natural Language Processing (EMNLP) (pp. 1724–1734). Association for Computational Linguistics. https://doi.org/10.3115/v1/D14-1179 (se abre en una pestaña nueva)
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press. Capítulo 5: Machine learning basics (se abre en una pestaña nueva). Capítulo 6: Deep feedforward networks (se abre en una pestaña nueva). Capítulo 8: Optimization for training deep models (se abre en una pestaña nueva)
Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017). On calibration of modern neural networks. En D. Precup & Y. W. Teh (Eds.), Proceedings of the 34th International Conference on Machine Learning (Vol. 70, pp. 1321–1330). PMLR. Actas del congreso (se abre en una pestaña nueva)
Hochreiter, S., & Schmidhuber, J. (1997). Long short-term memory. Neural Computation, 9(8), 1735–1780. https://doi.org/10.1162/neco.1997.9.8.1735 (se abre en una pestaña nueva)
Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323, 533–536. https://doi.org/10.1038/323533a0 (se abre en una pestaña nueva)
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. En I. Guyon, U. von Luxburg, S. Bengio, H. Wallach, R. Fergus, S. V. N. Vishwanathan, & R. Garnett (Eds.), Advances in Neural Information Processing Systems (Vol. 30, pp. 5998–6008). Curran Associates. Actas del congreso (se abre en una pestaña nueva)
Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K., & Cao, Y. (2023). ReAct: Synergizing reasoning and acting in language models. En The Eleventh International Conference on Learning Representations. Artículo de congreso — OpenReview (se abre en una pestaña nueva). Preprint — arXiv, v3 (se abre en una pestaña nueva)
Zhang, A., Lipton, Z. C., Li, M., & Smola, A. J. (2023). Dive into deep learning. Cambridge University Press. Libro y capítulos citados (se abre en una pestaña nueva)