Preguntas frecuentes sobre IA
¿Un LLM con más parámetros es mejor?
Qué significa 27B, por qué los parámetros totales y activos son distintos y cómo leer los límites de contexto, memoria y razonamiento sin confundir una ficha técnica con una medida de calidad.
Parámetros, contexto y esfuerzo de inferencia son dimensiones distintas. Ilustración conceptual; no representa la arquitectura de un modelo concreto.
Unos amigos debatían si un modelo de 27B era más inteligente que uno de 9B. La intuición se entiende: si tiene tres veces más parámetros, algo tendrá que hacer mejor. El problema aparece en ese salto de «tiene más» a «es mejor».
Dentro de una misma familia, con arquitectura y entrenamiento comparables, el modelo mayor suele rendir mejor. Entre familias o generaciones, la cantidad de parámetros por sí sola no decide. Esa es la distinción que necesitamos para responder: el tamaño aporta una expectativa útil cuando sabemos qué estamos comparando. Después importan la tarea y los recursos que concedemos al modelo para resolverla.
Un LLM es un modelo de lenguaje de gran tamaño: un modelo entrenado para procesar y generar lenguaje. Mantengamos a esos dos modelos de 9B y 27B como ejemplo hipotético y veamos qué cambia cuando abrimos su ficha técnica.
¿Qué significa 27B de parámetros?
Un parámetro es un valor numérico del modelo que puede ajustarse durante el entrenamiento. Muchos son pesos que intervienen en multiplicaciones; otros cumplen funciones distintas. Contamos valores aprendidos que, en conjunto, permiten representar regularidades del lenguaje. La correspondencia con palabras o hechos es distribuida, no de uno a uno.
Pensemos en un cálculo pequeño: . Aquí hay tres parámetros ajustables: dos pesos y un sesgo. Las entradas cambian en cada uso; los valores aprendidos determinan cómo se combinan. Un LLM contiene muchas operaciones y enormes conjuntos de estos valores. El ejemplo solo sirve para reconocer qué estamos contando.
En las fichas escritas en inglés, B significa billion: mil millones. Por tanto, 9B son 9 mil millones de parámetros y 27B son 27 mil millones. En español, un billón es un millón de millones: . Traducir 27 billion como «27 billones» multiplica la cifra por mil (Real Academia Española y ASALE, s. f. (se abre en una pestaña nueva)).
Tener más valores ajustables amplía la capacidad de representación. Las leyes de escalado describen una regularidad empírica: dentro de configuraciones comparables, aumentar el tamaño y disponer de datos suficientes tiende a reducir el error al predecir texto. Con datos y receta de entrenamiento comparables, esa evidencia favorece al hermano mayor de una familia. Es una tendencia medida sobre modelos y evaluaciones, con mejoras decrecientes; cada tarea concreta todavía requiere comprobar el resultado (Kaplan et al., 2020 (se abre en una pestaña nueva)).
El presupuesto de entrenamiento —la cantidad de cómputo dedicada a que el modelo aprenda— introduce otra comparación. Chinchilla es un modelo de lenguaje de 70B parámetros presentado en un estudio de 2022 que investigó cómo repartir ese presupuesto entre tamaño y cantidad de texto de entrenamiento. Se entrenó con más tokens —las unidades en que se divide el texto, como palabras, fragmentos o signos— que Gopher, otro modelo de lenguaje, de 280B. Con un presupuesto de cómputo aproximadamente equivalente, Chinchilla lo superó en numerosas evaluaciones (Hoffmann et al., 2022 (se abre en una pestaña nueva)). Amplío esta comparación en ¿Qué es un LLM y cómo se entrena?, de la serie IA explicada.
Entre generaciones también puede invertirse el orden: un modelo pequeño mejor entrenado puede superar a uno grande anterior. Además de más datos, intervienen mejoras en el post-entrenamiento, que adapta el modelo a tareas e instrucciones. Una vía es la destilación: entrenar un modelo con ejemplos producidos por otro. DeepSeek-R1 documenta este procedimiento para transferir capacidades de razonamiento a modelos más pequeños (Guo et al., 2025 (se abre en una pestaña nueva)). Para nuestros 9B y 27B, ser hermanos comparables favorece al de 27B; cambiar de generación o de receta obliga a ampliar la comparación.
¿Qué modelos publican esa información?
Entre los modelos que nos interesa comparar están los modelos de frontera, los que se sitúan entre los más capaces de su momento. No todos divulgan el mismo detalle técnico: sus fichas pueden incluir resultados de evaluación y límites de uso sin revelar datos internos como la cantidad de parámetros. Antes de comparar cifras, necesitamos saber qué información tenemos disponible.
Esta selección reúne modelos recientes y una versión previa de DeepSeek cuyo desglose sirve como ejemplo. Las fuentes se consultaron el 4 de octubre de 2026; cada enlace lleva a la documentación del desarrollador, incluidas sus publicaciones en Hugging Face. La tabla separa las especificaciones que necesitamos interpretar.
| Modelo y fuente | Parámetros declarados | Contexto anunciado | Entrada máxima declarada por separado |
|---|---|---|---|
| Claude Opus 5.5 (Anthropic, s. f.-b (se abre en una pestaña nueva)) | No divulgados en la ficha consultada | 1M tokens | — |
| GPT-6 Astra (OpenAI, s. f. (se abre en una pestaña nueva)) | No divulgados en la ficha consultada | 1 050 000 tokens | 922 000 tokens |
| Gemini 3.1 Pro Preview (Google, s. f.-a (se abre en una pestaña nueva)) | No divulgados en la ficha consultada | — | 1 048 576 tokens |
| Mistral Medium 3.5 (Mistral AI, s. f. (se abre en una pestaña nueva)) | 128B; arquitectura densa | 256k tokens | — |
| Qwen3.6-35B-A3B (Qwen Team, s. f.-b (se abre en una pestaña nueva)) | 35B totales; 3B activos | 262 144 tokens nativos | — |
| DeepSeek-V4-Pro, preview anterior a 0813 (DeepSeek-AI, s. f.-a (se abre en una pestaña nueva)) | 1.6T totales; 49B activos | 1M tokens | — |
El guion indica que la ficha consultada no presenta ese límite por separado. Conservo k y M cuando la fuente anuncia miles o millones con esas abreviaturas.
Las tres primeras filas ya muestran algo útil: podemos comparar respuestas, límites y costos de modelos cuyo número de parámetros desconocemos. Elegir un modelo no exige conocer su tamaño interno. Publicar los pesos ofrece otras ventajas: inspeccionar y desplegar más del sistema. En ambos casos, la calidad se comprueba con resultados. Los límites de la tabla corresponden a las versiones y servicios documentados; una aplicación de chat puede imponer otros.
La versión oficial DeepSeek-V4-Pro-0813 reemplazó a esta preview; la nota 4 explica por qué conservo el ejemplo anterior y cómo difieren sus conteos.
¿Qué diferencia hay entre parámetros totales, activos y capas?
La arquitectura es fundamental para entender la eficiencia de un modelo: describe cómo se organizan y conectan sus componentes, lo que afecta al cómputo y la memoria necesarios para procesar cada token. En algunos de los modelos comerciales anteriores, la documentación pública ofrece solo una descripción parcial de ese diseño. Las arquitecturas densas y las mezclas de expertos permiten ver cómo distintas formas de distribuir el trabajo cambian los recursos que necesita una red.
En una arquitectura densa, los bloques de cómputo usan sus pesos sin seleccionar un pequeño grupo de expertos para cada token. En una mezcla de expertos, o Mixture of Experts (MoE), determinados bloques contienen varias redes alternativas. Un enrutador calcula cuáles utilizar para el token que está procesando, y sus resultados se combinan. El nombre puede hacernos imaginar a un médico, un abogado y un programador turnándose. Esos «expertos» son subredes que aprenden cálculos distintos; sus funciones no tienen por qué corresponder a temas reconocibles. El análisis de enrutamiento de Mixtral no encontró patrones evidentes de asignación por tema (Jiang et al., 2024, §5 (se abre en una pestaña nueva)).
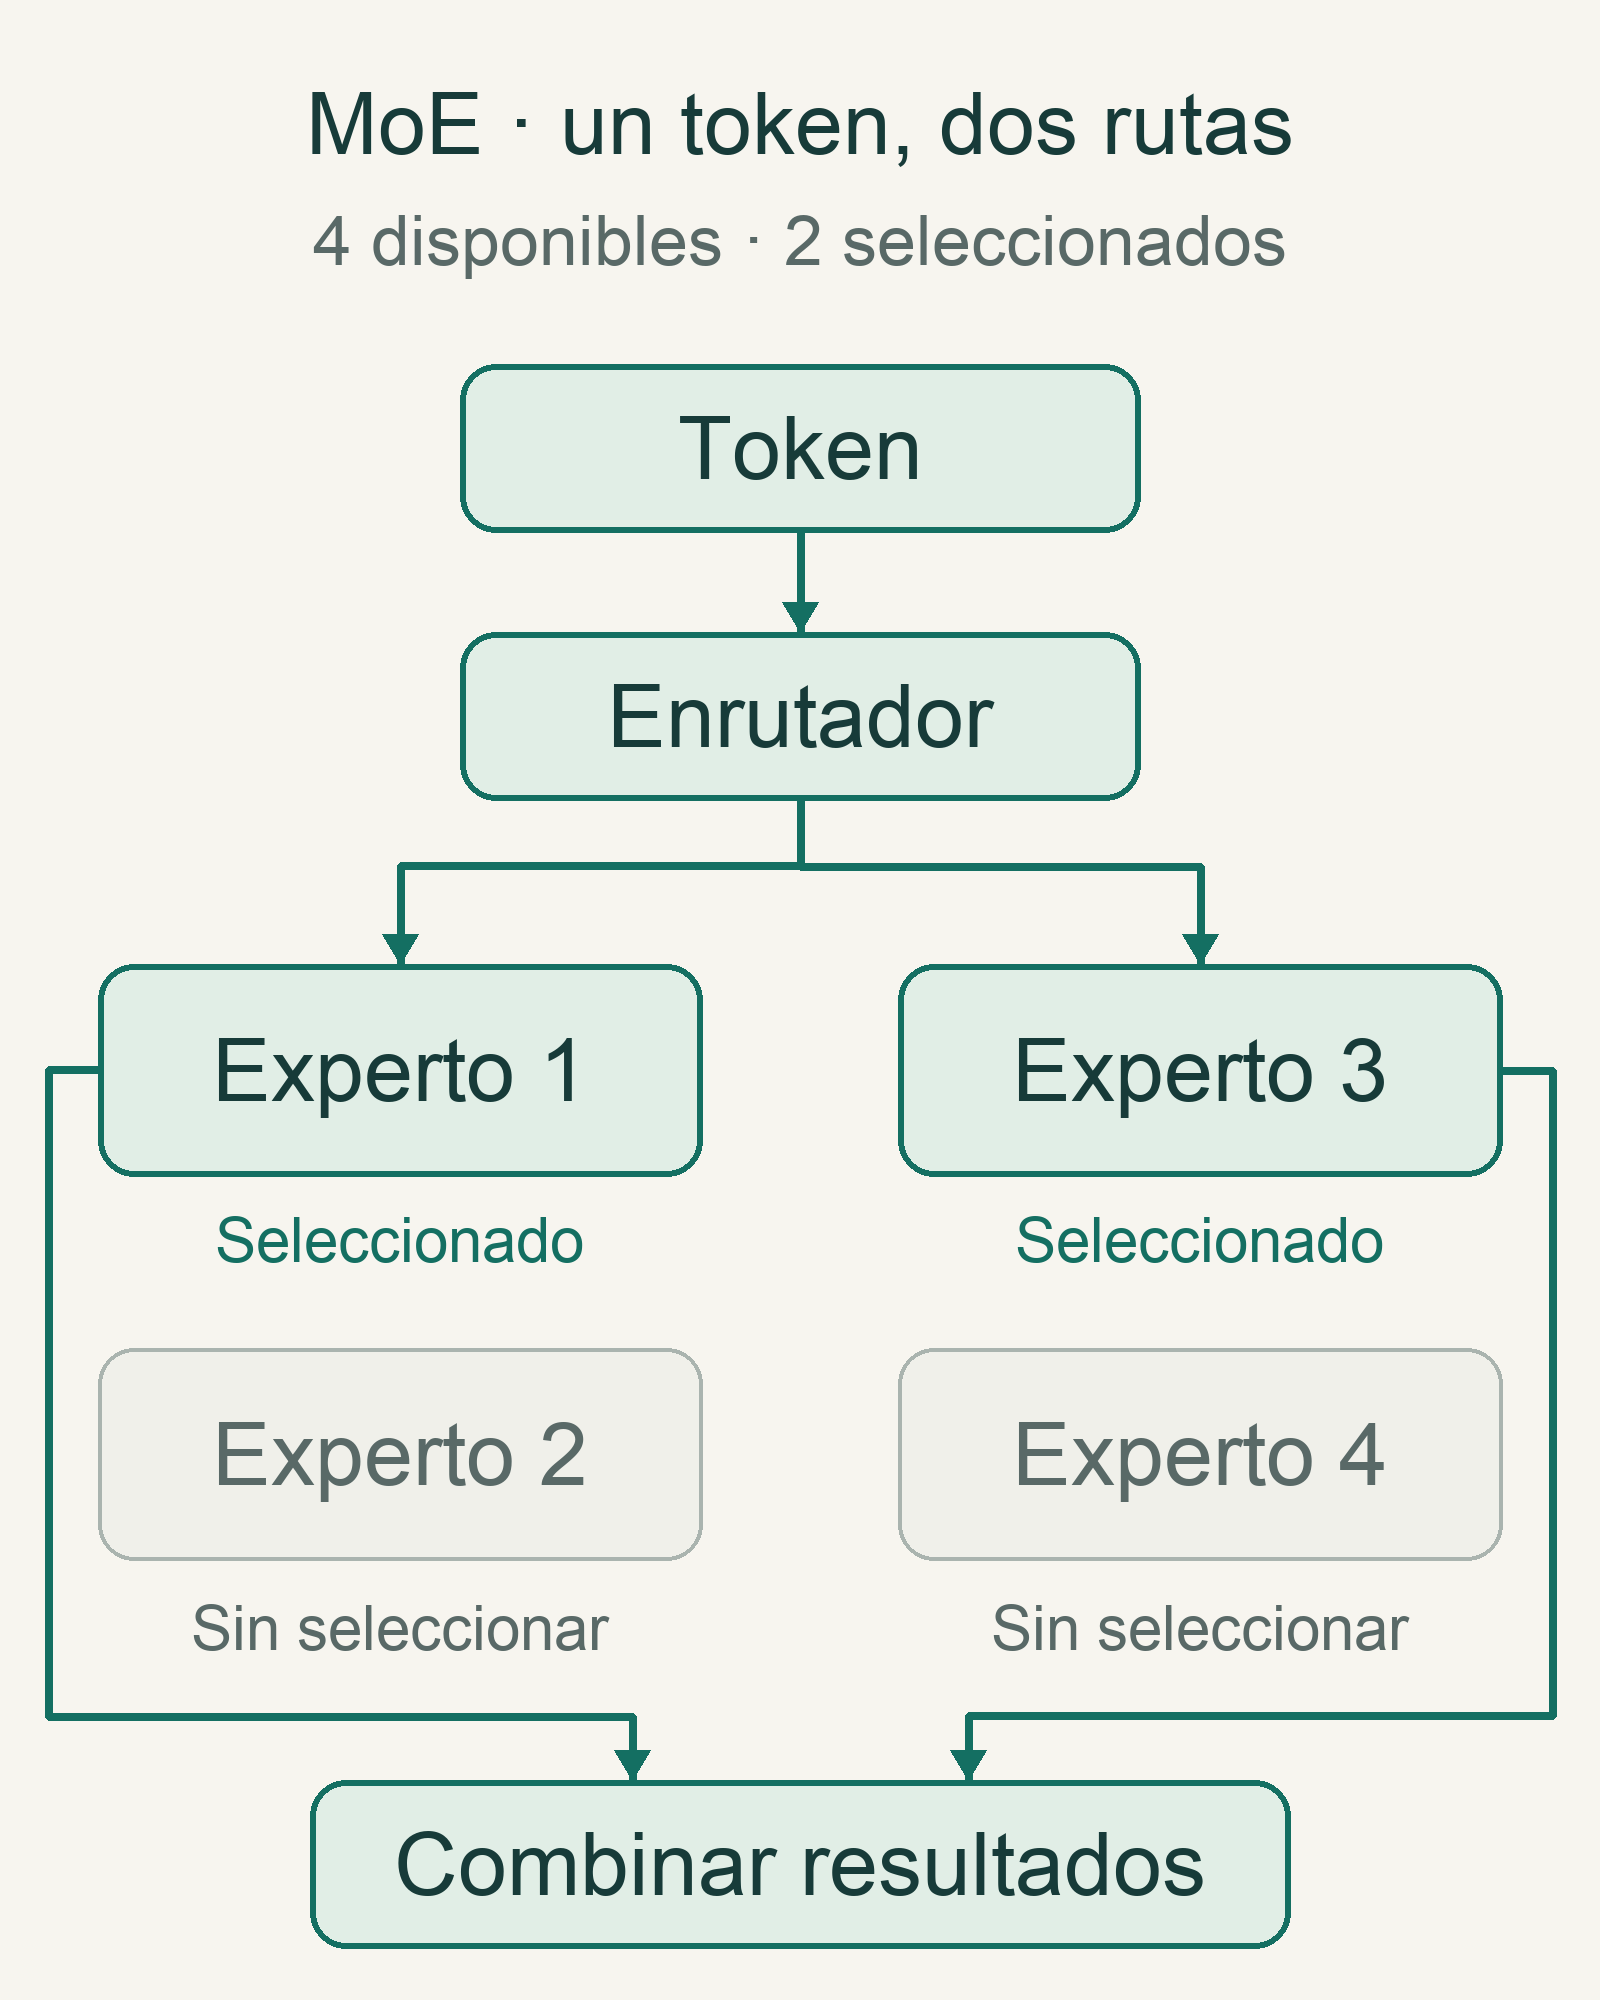
Ejemplo didáctico con cuatro expertos y dos seleccionados. No representa la arquitectura exacta de ninguno de los modelos de la tabla. Otro token puede seguir otra ruta.
Los parámetros totales incluyen todos esos pesos; los activos por token describen la parte que participa en su procesamiento, incluidos los componentes compartidos según la convención de la ficha. Por eso un MoE puede ampliar su cantidad total de parámetros sin usar todos sus expertos en cada paso. Esa es su ventaja. Su costo es mantener disponibles los pesos y gestionar el enrutamiento y, según el despliegue, la comunicación entre dispositivos (Jiang et al., 2024 (se abre en una pestaña nueva)).
La preview de DeepSeek-V4-Pro permite seguir ambas cuentas. La T significa trillion: sus 1.6T equivalen a 1 600B, o 1.6 billones en español. Por tanto, guardar el modelo completo exige almacenar sus 1 600B de parámetros, aunque por token se activen 49B. Dividir 1 600 entre 49 no da un multiplicador fiable de velocidad respecto a un modelo denso de 1 600B: intervienen atención, memoria, comunicación y hardware. Su ficha también especifica FP4 para los expertos y FP8 para la mayoría de los demás parámetros. El espacio ocupado depende tanto de cuántos valores guardamos como de su representación.
Las capas cuentan etapas sucesivas de procesamiento. Un bloque MoE puede estar dentro de una capa. Qwen3.6-35B-A3B, por ejemplo, declara 40 capas y, en sus bloques MoE, 8 expertos enrutados activos más uno compartido. Eso significa 9 expertos por bloque MoE y por token, no 9 capas activas ni 3 mil millones de capas (Qwen Team, s. f.-b (se abre en una pestaña nueva)). Cuando aparece «capas efectivas», necesitamos conocer la definición utilizada.
Qwen permite además comparar modelos de la misma generación. La ficha de Qwen3.6-27B informa 59.3 para ese modelo denso frente a 51.5 para Qwen3.6-35B-A3B en Terminal-Bench 2.0, una prueba de trabajo con terminal; en SWE-bench Verified, una prueba de resolución de problemas de software, las puntuaciones son 77.2 frente a 73.4. El denso queda por delante en ambas. Son resultados del desarrollador bajo sus condiciones de evaluación. Hemos mantenido la generación, mientras que arquitectura y tamaño siguen cambiando: 27B densos frente a 35B totales y 3B activos del MoE. La comparación muestra por qué los parámetros totales, por sí solos, no ordenan la calidad: el MoE contiene más y queda detrás en ambas pruebas (Qwen Team, s. f.-a (se abre en una pestaña nueva)).
Ya tenemos dos preguntas separadas: cuánto contiene el modelo y cuánto moviliza por token. Para saber si cabe en nuestra computadora hace falta una tercera: cómo se guardan esos números.
¿Más parámetros requieren más memoria?
A igual representación numérica, almacenar más parámetros requiere más espacio. Pero no todas las versiones guardan cada peso con la misma cantidad de bits. La cuantización reduce la precisión con la que se representan ciertos valores para ahorrar memoria; puede alterar la calidad y sus efectos dependen del método y de la tarea. Un modelo cuantizado puede conservar el mismo número de parámetros. OPTQ, difundido inicialmente como GPTQ, es un método para cuantizar pesos ya entrenados (Frantar et al., 2023 (se abre en una pestaña nueva)).
Volvamos a 9B y 27B. Este es un cálculo idealizado del espacio de sus pesos, usando GB decimales:
| Caso hipotético | Cálculo | Solo pesos |
|---|---|---|
| 9B a 16 bits | bytes | 18 GB |
| 27B a 16 bits | bytes | 54 GB |
| 27B a 4 bits | bytes | 13.5 GB |
El modelo mayor puede ocupar menos espacio en pesos si los representamos con menos bits. Para obtener los requisitos completos de RAM o VRAM hay que sumar metadatos de cuantización, memoria temporal y el estado necesario para procesar el contexto. La nota 1 explica esos componentes y la diferencia entre GB y GiB.
En modelos densos comparables en lo demás, más parámetros suelen requerir más cómputo por token. El tiempo real depende también de la arquitectura y la implementación. Cuantizar puede permitir una ejecución que antes no cabía en memoria; su conveniencia depende de la calidad obtenida y del soporte del hardware. Cuando usamos una API, parte de esta ingeniería queda del lado del servicio y la evaluamos a través de sus límites, tiempos y costos.
¿Una ventana de contexto mayor permite aprovechar mejor los documentos?
Los parámetros son parte del modelo aprendido. El contexto es la información disponible durante una ejecución: instrucciones, conversación, documentos y resultados de herramientas, además del espacio que requiere la generación según las reglas del servicio. Un documento aportado a una consulta entra en ese contexto; conservarlo para otras conversaciones requiere un mecanismo adicional del producto. Durante la ejecución, un contexto mayor suele ocupar más memoria para la caché de atención, el puente con la RAM o VRAM de la sección anterior (Anthropic, s. f.-a (se abre en una pestaña nueva)).
Ese espacio se mide en tokens, las unidades de procesamiento del texto que encontramos al hablar del entrenamiento. Su equivalencia en palabras o páginas depende del tokenizador. Las imágenes y otros medios tienen sus propias reglas de conteo. Para una carga real conviene usar el contador del modelo (Google, s. f.-b (se abre en una pestaña nueva)).
Una ventana amplia permite aportar más material de una vez. El límite de salida indica cuánto puede generar. GPT-6 Astra declara las tres cifras: 1 050 000 tokens de contexto, 922 000 de entrada y 128 000 de salida. La entrada coincide con el contexto menos la salida máxima. En cuanto a salida, Claude Opus 5.5 declara 128K en solicitudes estándar o 300K en la Batch API, en beta; Gemini 3.1 Pro Preview, 65 536. Son límites diferentes del contexto o la entrada. La nota 2 muestra cómo presupuestar entrada y generación, incluido el razonamiento que use ese mismo espacio.
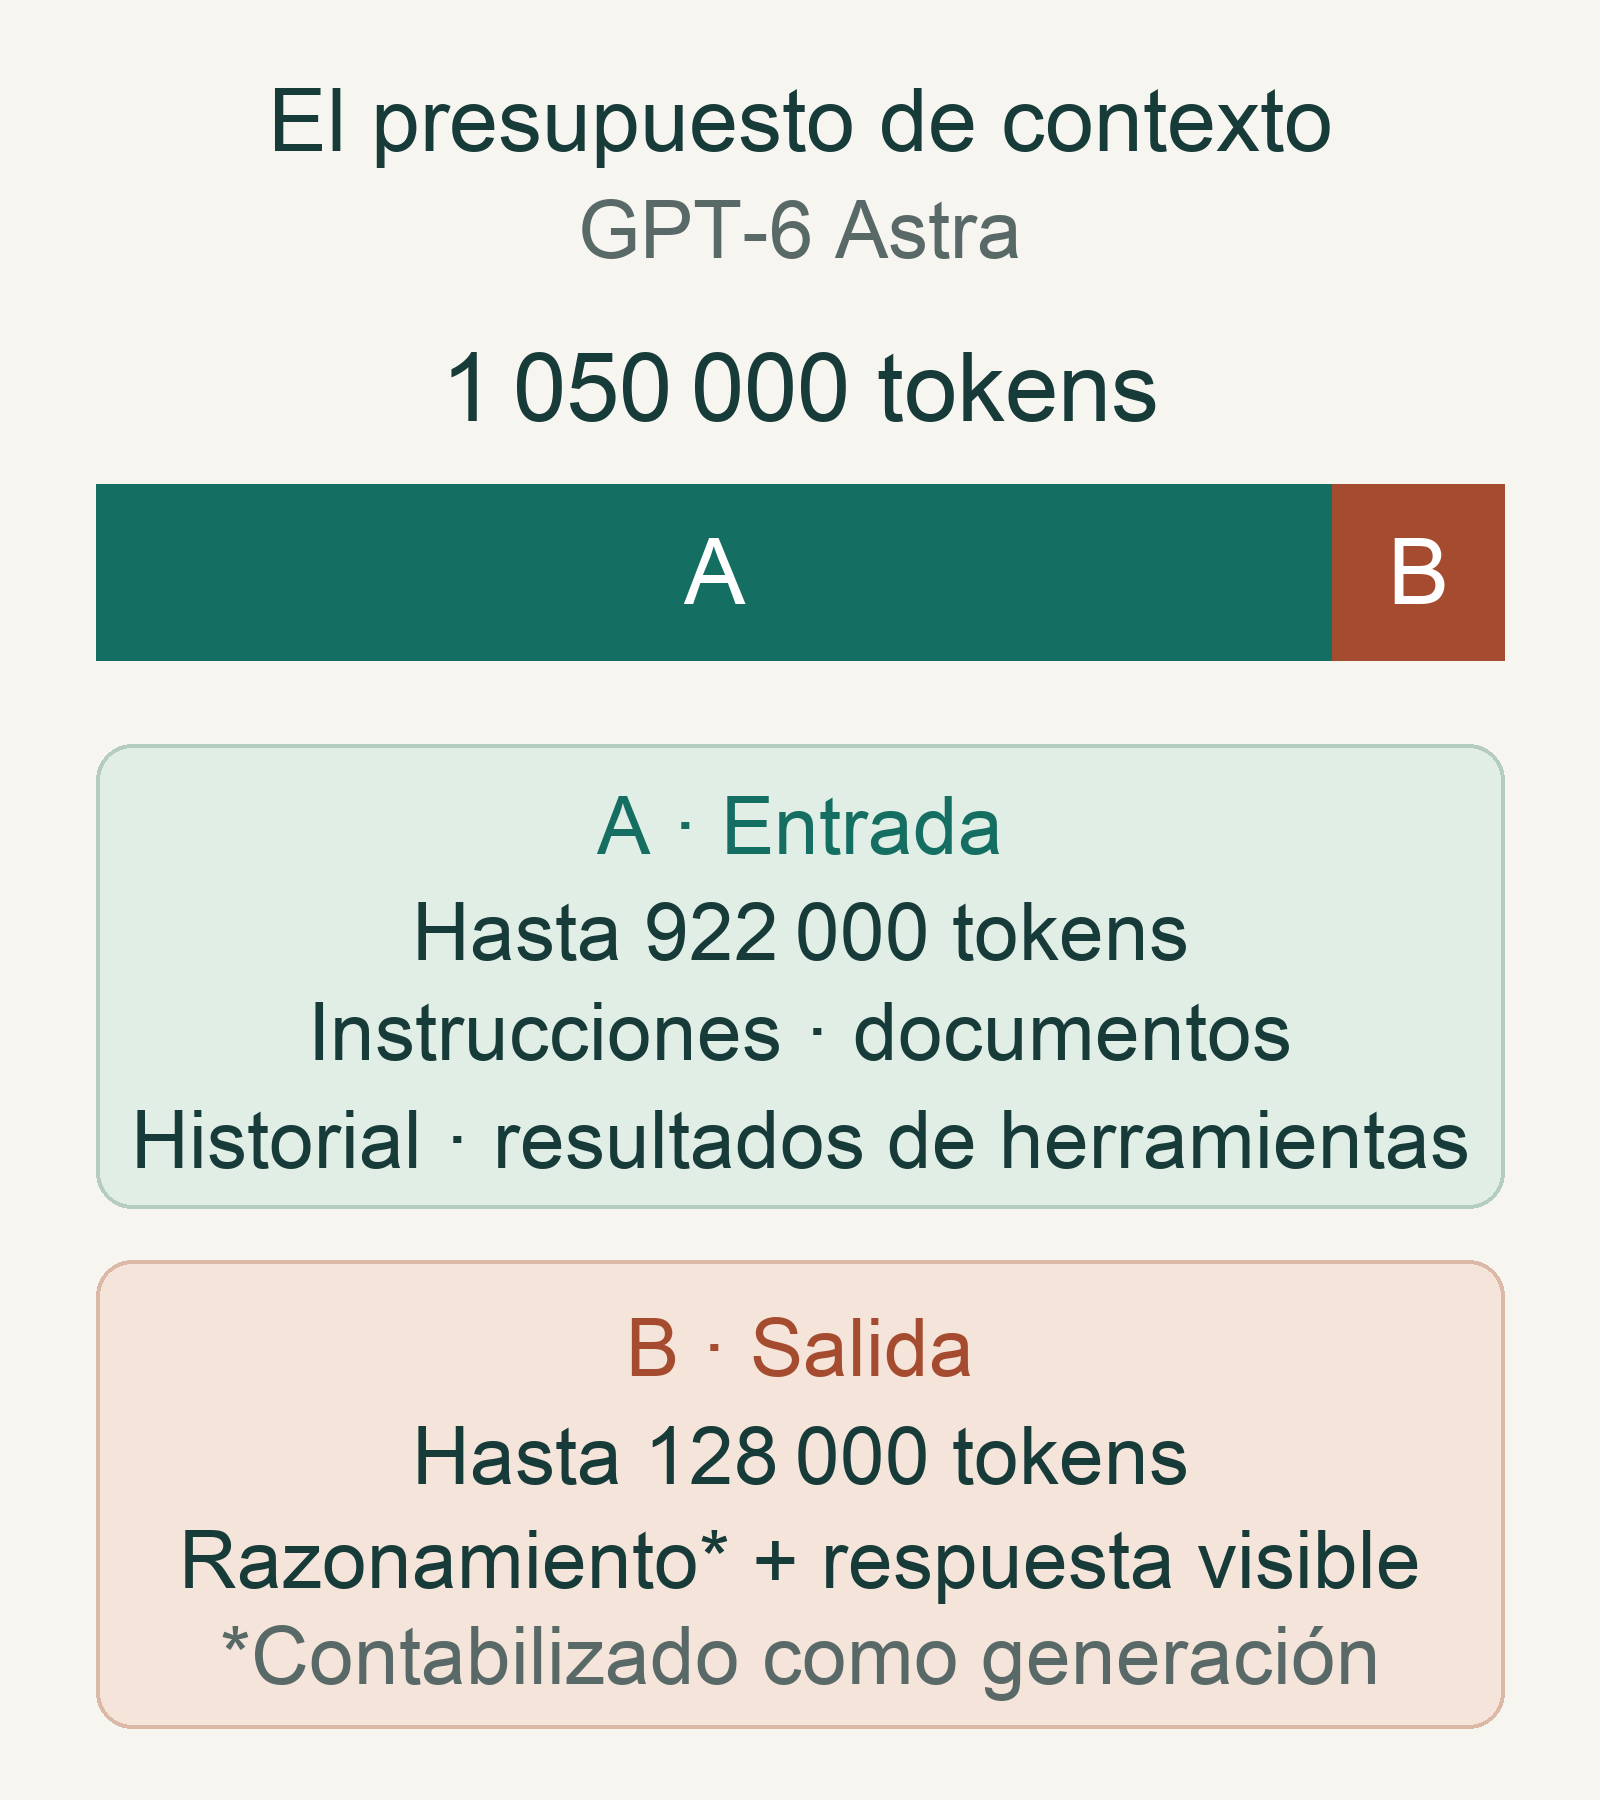
Máximos declarados por GPT-6 Astra, representados a escala (OpenAI, s. f. (se abre en una pestaña nueva)). Con 900 000 tokens de entrada quedan 150 000 en el contexto, pero el tope de salida sigue en 128 000. El esquema muestra capacidad; el aprovechamiento del contenido se evalúa aparte.
Imaginemos que necesitamos encontrar contradicciones entre varios informes. Una ventana mayor permite incluir más documentos; aprovecharlos exige relacionar sus pasajes. Lost in the Middle, publicado en 2024 con evaluaciones de modelos de 2023, mostró que la posición de la información afectaba el resultado (Liu et al., 2024 (se abre en una pestaña nueva)). NoLiMa, publicado en ICML 2025, añadió una prueba con pocas palabras compartidas entre la pregunta y el pasaje relevante. A 32K tokens, 11 de los 13 modelos evaluados caían por debajo de la mitad de su rendimiento con contextos cortos. Buscar asociaciones resultó más difícil al alargar el material, incluso cuando el contexto admitido era mucho mayor (Modarressi et al., 2025 (se abre en una pestaña nueva)).
Para nuestros informes variaríamos posición, longitud y coincidencia de vocabulario: preguntas con pruebas al principio, en medio y al final; versiones breves y largas de los documentos; preguntas que describan una idea con palabras distintas de las del pasaje. También incluiríamos contradicciones que exijan combinar fragmentos. Así medimos si el modelo aprovecha el espacio disponible para el trabajo que necesitamos.
¿Por qué el mismo modelo puede responder mejor si tarda más?
El entrenamiento determina los pesos. Al responder, en la inferencia, también podemos asignar más cómputo. Mistral Medium 3.5 permite configurar el esfuerzo de razonamiento por petición con los mismos pesos (Mistral AI, s. f. (se abre en una pestaña nueva)).
En un modelo que razona mediante texto intermedio, la generación continúa antes de la respuesta final: propone pasos, calcula y puede revisar un intento. En la decodificación autorregresiva ordinaria, cada nuevo token requiere otra pasada por el modelo, reutilizando la caché de atención; la secuencia anterior sirve de entrada para el siguiente paso. Más pasos proporcionan más cómputo en serie con los mismos parámetros. La ficha de Qwen muestra esa separación entre contenido de razonamiento y respuesta (Qwen Team, s. f.-b (se abre en una pestaña nueva)).
La preview de DeepSeek-V4-Pro permite ver el efecto con un mismo modelo. En GPQA Diamond, su desarrollador informa 72.9 en modo Non-Think, 89.1 en High y 90.1 en Max. Las ganancias bajan de 16.2 a 1.0 puntos porcentuales, lo que recuerda las mejoras decrecientes comentadas al hablar del escalado. También conviene considerar el efecto techo: alrededor de 90 sobre 100 queda menos margen de mejora. El resultado depende de la prueba; las etiquetas de esfuerzo son controles de cada sistema, de modo que estos saltos no tienen por qué representar incrementos iguales de cómputo (DeepSeek-AI, s. f.-a (se abre en una pestaña nueva)).
Volvamos a nuestros 9B y 27B. En un problema de varios pasos, dar al de 9B espacio para desarrollar y revisar una solución podría cambiar el resultado frente al de 27B con una respuesta directa. Es una hipótesis que probaríamos con esos modelos, no una medición realizada aquí. La comparación útil registra aciertos, espera y consumo: el esfuerzo adicional vale lo que mejora nuestra tarea.
Para hablar de rapidez conviene separar tiempo hasta empezar a recibir una respuesta útil, velocidad de generación y tiempo hasta terminar. Un servicio puede generar muchos tokens por segundo después de una espera larga. Artificial Analysis distingue incluso el primer token de razonamiento del primer token de la respuesta final (Artificial Analysis, s. f.-b (se abre en una pestaña nueva)).
El costo por tarea combina cuánto enviamos, cuánto genera el modelo, qué razonamiento se factura y cuántos intentos o herramientas necesitamos. La nota 3 muestra un cálculo con tarifas hipotéticas. Con esos componentes podemos comparar costos por respuesta correcta, además de precios por millón de tokens.
Entonces, ¿cómo elijo un LLM?
Después de entender las cifras, necesitamos darles un trabajo concreto. Para comparar informes en español, empezaría con un pequeño conjunto de documentos y preguntas cuyas respuestas pueda comprobar. Incluiría contradicciones, información repartida entre documentos y preguntas cuya respuesta no aparezca. Así podemos observar tanto aciertos como respuestas inventadas.
Las fichas ayudan a descartar incompatibilidades: contexto insuficiente, salida demasiado corta o una modalidad que no admite nuestros archivos. Gemini 3.1 Pro Preview, por ejemplo, documenta entrada de texto, imágenes, audio, video y PDF, y salida de texto. Conviene revisar ambas direcciones cuando una ficha dice «multimodal». Después de ese filtro, compararía:
- Calidad en la tarea: respuestas correctas, pruebas que realmente las respalden y cumplimiento de instrucciones. Si usamos código, pruebas ejecutables; si usamos documentos, pasajes verificables.
- Condiciones de ejecución: versión exacta, esfuerzo de razonamiento, herramientas y cuantización, cuando corresponda. Un resultado solo describe las condiciones en que se obtuvo.
- Recursos necesarios: tiempo hasta la respuesta completa, costo por caso resuelto y, si ejecutamos localmente, memoria y hardware.
- Condiciones de uso: tratamiento de los datos, posibilidades de despliegue y licencia aplicable. Tener acceso a los pesos no implica ausencia de restricciones.
Un benchmark, o conjunto de pruebas de evaluación, puede orientar esa selección inicial. Su puntuación resume pruebas y condiciones concretas. El índice de inteligencia de Artificial Analysis evalúa texto en inglés; la organización publica aparte un índice multilingüe basado en Global-MMLU-Lite que incluye español. Este último se acerca más a nuestro idioma de trabajo, aunque los informes y las preguntas que preparamos siguen siendo la prueba decisiva (Artificial Analysis, s. f.-a (se abre en una pestaña nueva)).
Podemos volver ahora a la conversación entre amigos con una respuesta más precisa. Si 9B y 27B son hermanos con arquitectura, datos y entrenamiento comparables, el mayor parte con una expectativa favorable de calidad, a cambio de más recursos. Si cambian la generación, la arquitectura o el esfuerzo de razonamiento, necesitamos mirar esas diferencias: un modelo menor puede resultar mejor para la tarea. Las especificaciones nos permiten formular una comparación justa; nuestras pruebas convierten esa expectativa en una decisión.
Notas
- Espacio de pesos y memoria de ejecución. La aproximación es bytes, con parámetros y bits por parámetro. Supone una precisión uniforme y no incluye escalas u otros metadatos. Aquí 1 GB equivale a bytes; 1 GiB equivale a bytes. Durante la generación suele mantenerse una caché de claves y valores (KV) para reutilizar cálculos de atención. Su tamaño depende del contexto, la arquitectura, la precisión y las peticiones simultáneas. Las cachés pueden comprimirse o trasladarse entre dispositivos con efectos sobre memoria y velocidad (Hugging Face, s. f.-a (se abre en una pestaña nueva)). En una GPU con 16 GiB, unos 17.2 GB decimales, 13.5 GB de pesos dejarían unos 3.7 GB para los demás componentes. Que alcancen depende de la ejecución. Volver al cálculo.
- Presupuestar entrada y salida con una ficha real. GPT-6 Astra publica 1 050 000 tokens de contexto, un máximo de entrada de 922 000 y un máximo de salida de 128 000. La suma reúne los tres límites declarados: el máximo de entrada coincide con el espacio que queda al reservar la salida máxima. Con 900 000 tokens de entrada quedarían 150 000 en el contexto, mientras que el máximo de salida seguiría siendo 128 000. El razonamiento contabilizado como generación comparte ese presupuesto de salida con la respuesta visible. La versión Markdown de la ficha enumera expresamente las tres cifras (OpenAI, s. f. (se abre en una pestaña nueva)). Volver al contexto.
- Tarifa y costo total. Con precios hipotéticos de 2 USD por millón de tokens de entrada y 10 USD por millón de salida, una petición de 10 000 tokens de entrada y 1 000 facturados de salida costaría USD. Son tres centavos bajo esas condiciones. El cálculo excluye herramientas, descuentos, caché y cualquier otra tarifa; si el razonamiento se cobra como salida, sus tokens deben incluirse. Las tarifas sirven solo para este ejemplo. Volver a costos.
- ¿Qué paquete de DeepSeek estamos contando? La versión oficial DeepSeek-V4-Pro-0813 reemplaza a la preview y añade el módulo de decodificación especulativa DSpark (DeepSeek-AI, s. f.-b (se abre en una pestaña nueva)). En la fecha de consulta, el campo
safetensors.totalde la API de Hugging Face devolvía 1 650 497 936 906 para 0813, aproximadamente 1.65T, frente a 1 598 839 674 782 para la preview, aproximadamente 1.60T (Hugging Face, s. f.-b (se abre en una pestaña nueva); Hugging Face, s. f.-c (se abre en una pestaña nueva)). La interfaz redondea el primero a 1.7T. Son conteos de valores de los tensores del repositorio obtenidos por el mismo método; atribuir toda la diferencia a un módulo concreto exigiría un desglose por componentes. Conservo la preview identificada porque su ficha documenta tanto los parámetros totales y activos como los tres modos de razonamiento comparados aquí. Volver a la tabla.
Referencias
Anthropic. (s. f.-a). Context windows. Claude API Docs. Recuperado el 4 de octubre de 2026, de Fuente original (se abre en una pestaña nueva)
Anthropic. (s. f.-b). Opus 5.5. Claude API Docs. Recuperado el 4 de octubre de 2026, de Fuente original (se abre en una pestaña nueva)
Artificial Analysis. (s. f.-a). Artificial Analysis Intelligence Index. Recuperado el 4 de octubre de 2026, de Fuente original (se abre en una pestaña nueva)
Artificial Analysis. (s. f.-b). Language model API performance benchmarking. Recuperado el 4 de octubre de 2026, de Fuente original (se abre en una pestaña nueva)
DeepSeek-AI. (s. f.-a). DeepSeek-V4-Pro [Ficha de modelo]. Hugging Face. Recuperado el 4 de octubre de 2026, de Ficha del modelo (se abre en una pestaña nueva)
DeepSeek-AI. (s. f.-b). DeepSeek-V4-Pro-0813 [Ficha de modelo]. Hugging Face. Recuperado el 4 de octubre de 2026, de Ficha del modelo (se abre en una pestaña nueva)
Frantar, E., Ashkboos, S., Hoefler, T. y Alistarh, D. (2023). OPTQ: Accurate post-training quantization for generative pre-trained transformers. En The Eleventh International Conference on Learning Representations. Versión publicada, repositorio institucional (se abre en una pestaña nueva)
Google. (s. f.-a). Gemini 3.1 Pro Preview. Google AI for Developers. Recuperado el 4 de octubre de 2026, de Fuente original (se abre en una pestaña nueva)
Google. (s. f.-b). Understand and count tokens. Google AI for Developers. Recuperado el 4 de octubre de 2026, de Fuente original (se abre en una pestaña nueva)
Guo, D., Yang, D., Zhang, H., Song, J., Wang, P., Zhu, Q., Xu, R., Zhang, R., Ma, S., Bi, X., Zhang, X., Yu, X., Wu, Y., Wu, Z. F., Gou, Z., Shao, Z., Li, Z., Gao, Z., Liu, A., . . . Zhang, Z. (2025). DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning. Nature, 645, 633–638. DOI (se abre en una pestaña nueva)
Hoffmann, J., Borgeaud, S., Mensch, A., Buchatskaya, E., Cai, T., Rutherford, E., de Las Casas, D., Hendricks, L. A., Welbl, J., Clark, A., Hennigan, T., Noland, E., Millican, K., van den Driessche, G., Damoc, B., Guy, A., Osindero, S., Simonyan, K., Elsen, E., . . . Sifre, L. (2022). An empirical analysis of compute-optimal large language model training. En S. Koyejo, S. Mohamed, A. Agarwal, D. Belgrave, K. Cho y A. Oh (Eds.), Advances in Neural Information Processing Systems (Vol. 35, pp. 30016–30030). Curran Associates. DOI (se abre en una pestaña nueva)
Hugging Face. (s. f.-a). Cache strategies. Transformers. Recuperado el 4 de octubre de 2026, de Fuente original (se abre en una pestaña nueva)
Hugging Face. (s. f.-b). DeepSeek-V4-Pro [Metadatos de Safetensors]. Recuperado el 4 de octubre de 2026, de Registro de la API (se abre en una pestaña nueva)
Hugging Face. (s. f.-c). DeepSeek-V4-Pro-0813 [Metadatos de Safetensors]. Recuperado el 4 de octubre de 2026, de Registro de la API (se abre en una pestaña nueva)
Jiang, A. Q., Sablayrolles, A., Roux, A., Mensch, A., Savary, B., Bamford, C., Chaplot, D. S., de las Casas, D., Hanna, E. B., Bressand, F., Lengyel, G., Bour, G., Lample, G., Lavaud, L. R., Saulnier, L., Lachaux, M.-A., Stock, P., Subramanian, S., Yang, S., . . . El Sayed, W. (2024). Mixtral of experts [Prepublicación]. arXiv. arXiv (se abre en una pestaña nueva)
Kaplan, J., McCandlish, S., Henighan, T., Brown, T. B., Chess, B., Child, R., Gray, S., Radford, A., Wu, J. y Amodei, D. (2020). Scaling laws for neural language models [Prepublicación]. arXiv. arXiv (se abre en una pestaña nueva)
Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F. y Liang, P. (2024). Lost in the middle: How language models use long contexts. Transactions of the Association for Computational Linguistics, 12, 157–173. DOI (se abre en una pestaña nueva)
Mistral AI. (s. f.). Mistral Medium 3.5 128B [Ficha de modelo]. Hugging Face. Recuperado el 4 de octubre de 2026, de Ficha del modelo (se abre en una pestaña nueva)
Modarressi, A., Deilamsalehy, H., Dernoncourt, F., Bui, T., Rossi, R. A., Yoon, S. y Schuetze, H. (2025). NoLiMa: Long-context evaluation beyond literal matching. En A. Singh, M. Fazel, D. Hsu, S. Lacoste-Julien, F. Berkenkamp, T. Maharaj, K. Wagstaff y J. Zhu (Eds.), Proceedings of the 42nd International Conference on Machine Learning (Vol. 267, pp. 44554–44570). PMLR. Actas (se abre en una pestaña nueva)
OpenAI. (s. f.). GPT-6 Astra. OpenAI API. Recuperado el 4 de octubre de 2026, de Fuente original (se abre en una pestaña nueva) · Versión Markdown (se abre en una pestaña nueva)
Qwen Team. (s. f.-a). Qwen3.6-27B [Ficha de modelo]. Hugging Face. Recuperado el 4 de octubre de 2026, de Ficha del modelo (se abre en una pestaña nueva)
Qwen Team. (s. f.-b). Qwen3.6-35B-A3B [Ficha de modelo]. Hugging Face. Recuperado el 4 de octubre de 2026, de Ficha del modelo (se abre en una pestaña nueva)
Real Academia Española y Asociación de Academias de la Lengua Española. (s. f.). Billón. En Diccionario panhispánico de dudas (2.ª ed.). Recuperado el 4 de octubre de 2026, de Entrada del diccionario (se abre en una pestaña nueva)