IA explicada
¿Qué es un LLM y cómo se entrena?
Sigue una frase sobre un pescador entre predicciones, pérdida y ajustes de parámetros para entender qué cambia en el preentrenamiento, qué aporta la escala y cómo se comprueba el aprendizaje.
Artículo 7 de 7 · Orden de lectura
Escribamos «El pescador reparó su red». Tapemos la última palabra y dejemos a la vista «El pescador reparó su…». Quizás hayas pensado en «red», aunque «bote» también podría funcionar. Nosotros podemos imaginar al pescador junto al agua. Para entrenar un modelo de lenguaje, esa escena se convierte en algo que una computadora puede calcular: repartir probabilidades entre posibles continuaciones y compararlas con lo que decía el texto.
Una frase, una continuación por anticipar y varios intentos de ajuste. Acuarela conceptual; las tarjetas y las correcciones representan el ejercicio, no los cálculos internos de un modelo.
En la entrega del Transformer, seguimos a este pescador mientras su frase se traducía. También vimos cómo se prepara el material de entrenamiento. Ahora veremos cómo un modelo aprende a anticipar una continuación. Tener una arquitectura y una colección de textos todavía deja una tarea por resolver: encontrar los valores numéricos con los que esa arquitectura hará predicciones útiles.
Al terminar, podrás distinguir los datos, el objetivo, la arquitectura y el modelo entrenado, y recorrer un ciclo de preentrenamiento: qué entra, qué se predice, cómo se mide la diferencia y qué cambia después. Seguiremos al pescador durante ese recorrido. No hace falta haber leído toda la serie; recuperaremos cada idea cuando la necesitemos.
Un modelo para las continuaciones posibles
Un modelo de lenguaje asigna probabilidades a secuencias de tokens, las unidades en que se divide el texto para procesarlo. En el tipo que seguiremos aquí, calcula la distribución del siguiente token a partir de los anteriores. Eso permite valorar una continuación y, más adelante, producir texto.
El modelado de lenguaje ya tenía una historia antes de las redes que seguimos aquí. Los modelos de n-gramas estimaban continuaciones a partir de secuencias cortas de palabras observadas en los textos, combinando contextos de distinta longitud para afrontar casos nuevos (Bengio et al., 2003, sección 1 (se abre en una pestaña nueva)). Frente a ese enfoque, Yoshua Bengio y sus coautores presentaron en NIPS 2000 un modelo que aprendía conjuntamente representaciones de palabras y probabilidades de secuencias; la versión ampliada apareció en JMLR en 2003 (Bengio et al., 2000 (se abre en una pestaña nueva); 2003 (se abre en una pestaña nueva)). Compartir representaciones permitía que una frase informara sobre otras con palabras de representación cercana, incluso cuando la secuencia completa era nueva.
LLM viene de large language model: modelo de lenguaje de gran tamaño. El término suele referirse a redes con muchos parámetros, entrenadas con grandes cantidades de texto. «Grande» describe una escala; no hay una cifra única que marque una frontera universal. Los parámetros son los números ajustables de la red. Su cantidad, los tokens utilizados para entrenarla y el cómputo empleado describen aspectos distintos de esa escala.
Para hacer concreto el recorrido elegiremos un Transformer de solo decodificador, o decoder-only: la variante que ya vimos al pasar del traductor a los modelos que continúan texto. En ella, la misma secuencia aporta el contexto para predecir el siguiente token, sin un codificador separado al que consultar. Es un modelo autorregresivo. GPT-2 es un ejemplo documentado de esta elección (Radford et al., 2019, sección 2 (se abre en una pestaña nueva)). Hay otros diseños y objetivos de entrenamiento; esta será nuestra ruta para entender el mecanismo.
La frase trae su propia referencia
Volvamos a «El pescador reparó su red». Para ver la preparación de los ejemplos, imaginemos un tokenizador didáctico que deja cada palabra en un token y separa el punto final. Omitiremos los espacios en el esquema. Un tokenizador real puede dividir las palabras de otra manera; aquí importa la relación entre la entrada y lo que debe venir después.
| Texto disponible para la predicción | Siguiente token en el documento |
|---|---|
| El | pescador |
| El pescador | reparó |
| El pescador reparó | su |
| El pescador reparó su | red |
| El pescador reparó su red | . |
Una sola frase ofrece varias posiciones donde comparar una predicción con una referencia. El token objetivo es el que realmente aparece después en el documento. Al preparar el entrenamiento, el programa ya lo conoce: sale de desplazar una posición la misma secuencia de tokens.
De ahí el nombre de aprendizaje autosupervisado. No necesitamos que alguien escriba por separado la respuesta para cada prefijo; podemos obtenerla del material. Trabajos como el de GPT-2 lo describían como aprendizaje no supervisado —unsupervised, en su título—; aquí «autosupervisado» destaca de dónde salen los objetivos. Las decisiones humanas sobre qué textos entran siguen presentes, como vimos en la entrega anterior.
La referencia tampoco afirma que «red» sea la única continuación razonable. En otra frase el pescador podría reparar su bote. Este ejemplo aporta una observación; otros aportarán otras, y sus frecuencias y contextos también influirán en el aprendizaje. El procedimiento busca ajustar una distribución, en lugar de escribir una regla que exija siempre la misma palabra final.
Ver la frase sin adelantarse a la respuesta
Antes de aprender, necesitamos poner en marcha la red. En un entrenamiento desde cero, muchas matrices de pesos empiezan con valores aleatorios elegidos mediante una regla de inicialización; otros parámetros pueden empezar en valores fijos. Ya existe una estructura capaz de calcular, pero sus predicciones todavía no reflejan lo que buscamos aprender del corpus.
El recorrido hacia adelante comienza con identificadores de tokens que seleccionan filas de una tabla de embeddings, sus representaciones numéricas. La información de posición y los bloques del Transformer transforman esas representaciones. En el prefijo «El pescador reparó su», la salida de la última posición reúne información que la red utilizará para puntuar posibles continuaciones.
Una proyección de salida produce una puntuación, o logit, por token del vocabulario. Softmax transforma esas puntuaciones en probabilidades positivas que suman uno.
Para tener una línea base, usemos un vocabulario hipotético con 50 257 entradas, el tamaño documentado para GPT-2 (Radford et al., 2019, sección 2.3 (se abre en una pestaña nueva)). Con logits iguales, softmax reparte la probabilidad uniformemente: cada token recibe . Con logits muy próximos entre sí, el reparto sería casi uniforme. Esta referencia matemática nos da una escala; los logits de una red recién inicializada dependen de su diseño e inicialización.
Ahora construyamos una distribución hipotética más concentrada para poder seguir los cálculos. Asignaremos 0.10 a «red» por comodidad didáctica, sin atribuir estas cifras a una etapa concreta del entrenamiento:
| Continuación | Probabilidad |
|---|---|
| red | 0.10 |
| bote | 0.45 |
| canasta | 0.25 |
| Todos los demás tokens juntos | 0.20 |
La última fila reúne muchas alternativas; el modelo puntúa cada token por separado.
Hay una aparente trampa: si el programa tiene la frase completa, ¿cómo evitamos que la red mire «red» antes de predecirla? Aquí vuelve la máscara causal que usamos al recorrer el Transformer: impide que cada posición atienda a posiciones posteriores. La salida situada en «su» puede usar «El pescador reparó su», pero no «red» ni el punto que siguen. El Transformer original describe esa restricción junto con el desplazamiento de las salidas durante el entrenamiento (Vaswani et al., 2017, sección 3.1 (se abre en una pestaña nueva); detalle del manuscrito (se abre en una pestaña nueva)).
Como los prefijos de referencia ya están disponibles, un Transformer causal puede calcular las predicciones de muchas posiciones en paralelo, respetando la máscara en cada capa. Para calcular la predicción posterior a «red», utiliza el «red» del documento, aunque su predicción anterior hubiera favorecido «bote». Usar los tokens de referencia como contexto durante el entrenamiento se conoce como teacher forcing (Goodfellow et al., 2016, sección 10.2.1 (se abre en una pestaña nueva)). Cada comparación parte así del prefijo que proporciona el documento.
Darle un número a la diferencia
Nuestra distribución deja solo 0.10 de probabilidad a «red». Ahora necesitamos una medida que permita distinguirla de otra que le asigne 0.60. Decir únicamente «acertó» o «falló» perdería información sobre cuánto apoyo recibe la referencia.
La función de pérdida convierte esa comparación en un número. Usaremos la entropía cruzada con un único token objetivo: toma la probabilidad asignada a ese token y la transforma de modo que una probabilidad baja produzca una pérdida alta. La documentación de PyTorch presenta esa operación a partir de los logits (PyTorch contributors, s. f. (se abre en una pestaña nueva)).
En la línea base uniforme, la pérdida para cualquier token objetivo sería , es decir, . Ese es nuestro punto de comparación numérico.
Con logaritmos naturales, asignar 0.10 a «red» da una pérdida de aproximadamente 2.303; asignarle 0.60 da aproximadamente 0.511. Son dos distribuciones hipotéticas que estamos comparando, no una mejora garantizada después de un ajuste. La nota 1 desarrolla la fórmula y el promedio para una secuencia.
Esa pérdida mide algo muy preciso: cuánto apoyo recibió el token observado. Si el documento contuviera una afirmación falsa, el cálculo seguiría teniendo una referencia. En nuestro ejemplo sabemos qué escribió la persona; averiguar si un pescador reparó realmente una red sería otra tarea. Esta distinción pone un límite concreto a lo que podemos concluir cuando la pérdida baja.
El error encuentra los números que pueden cambiar
Hasta aquí la red hizo una predicción y recibió una medida de su desacuerdo con el texto. Ahora retomamos el ciclo de pérdida, gradiente y ajuste de la entrega sobre redes neuronales: allí cambiaban los pesos que ayudaban a reconocer un 3; aquí ajustaremos los que participan en anticipar la continuación del pescador.
La retropropagación, o backpropagation, calcula cómo respondería la pérdida a pequeños cambios en los parámetros que participaron en el cálculo. Esas derivadas forman el gradiente. Podemos interpretarlas como indicaciones locales: aumentar un número tendería a subir la pérdida; aumentar otro tendería a bajarla. El optimizador utiliza esas indicaciones para decidir el ajuste.
Con descenso de gradiente, damos un paso en la dirección que reduce la pérdida según esa estimación local. La tasa de aprendizaje regula su tamaño. Un paso demasiado grande puede deshacer la mejora que esperábamos; uno muy pequeño puede hacer lento el progreso. La explicación general del ciclo está desarrollada en Goodfellow et al. (2016, capítulo 8) (se abre en una pestaña nueva).
Podemos aislar un peso de la proyección de salida para observarlo. En el ejemplo numérico de la nota 2, ese peso pasa de 0.400 a 0.418. Si dejamos fijo todo lo demás, la probabilidad de «red» pasa de 0.10 a aproximadamente 0.1033. El ajuste es pequeño, pero ya podemos señalar qué cambió y recalcular su efecto.
En un entrenamiento completo, los gradientes también pueden llegar a los embeddings y a las transformaciones de atención y de las demás capas. Lo aprendido puede cambiar tanto las representaciones como la manera de combinarlas. Los pesos se comparten entre muchos contextos: un ajuste provocado por el pescador puede afectar otras frases. En general, no hay un parámetro aislado que podamos interpretar como «saber reparar redes».
El descenso de gradiente que acabamos de usar es una opción sencilla. Adam, por ejemplo, mantiene estimaciones de los gradientes y de sus cuadrados para adaptar las actualizaciones (Kingma y Ba, 2015 (se abre en una pestaña nueva)). Esas estimaciones cambian el tamaño de los pasos que reciben los distintos parámetros; seguimos usando los gradientes de la misma función de pérdida.
Una frase comparte el ajuste con muchas otras
Si solo repitiéramos nuestra oración, podríamos mejorar esa predicción sin construir un modelo útil para mucho más. Ahora pongamos junto a ella «La pescadora guardó su red», «El mecánico reparó su motor» y «La niña reparó su cometa». Son ejemplos inventados, pero dejan ver la dificultad: algunos contextos comparten una actividad, otros una persona o un objeto, y las continuaciones cambian.
Distintas frases pueden contribuir al ajuste de los mismos parámetros. Acuarela conceptual de nuestros ejemplos de texto.
En la práctica se reúnen secuencias en un lote, o batch. Se combinan las pérdidas de sus posiciones válidas y se calculan los gradientes de ese objetivo conjunto. En lugar de corregir cada frase por separado, la actualización combina sus contribuciones. Las posiciones añadidas solo como relleno pueden excluirse de la pérdida.
Nuestro ciclo queda así: preparar un lote, calcular sus distribuciones, compararlas con los tokens de referencia, obtener gradientes y actualizar los parámetros. Después llega otro lote y se repite. Un paso de entrenamiento suele referirse a una actualización del optimizador; puede reunir varios lotes pequeños mediante acumulación de gradientes. Una época es un recorrido por el conjunto de entrenamiento, aunque en colecciones muy grandes también se describe el avance contando los tokens procesados.
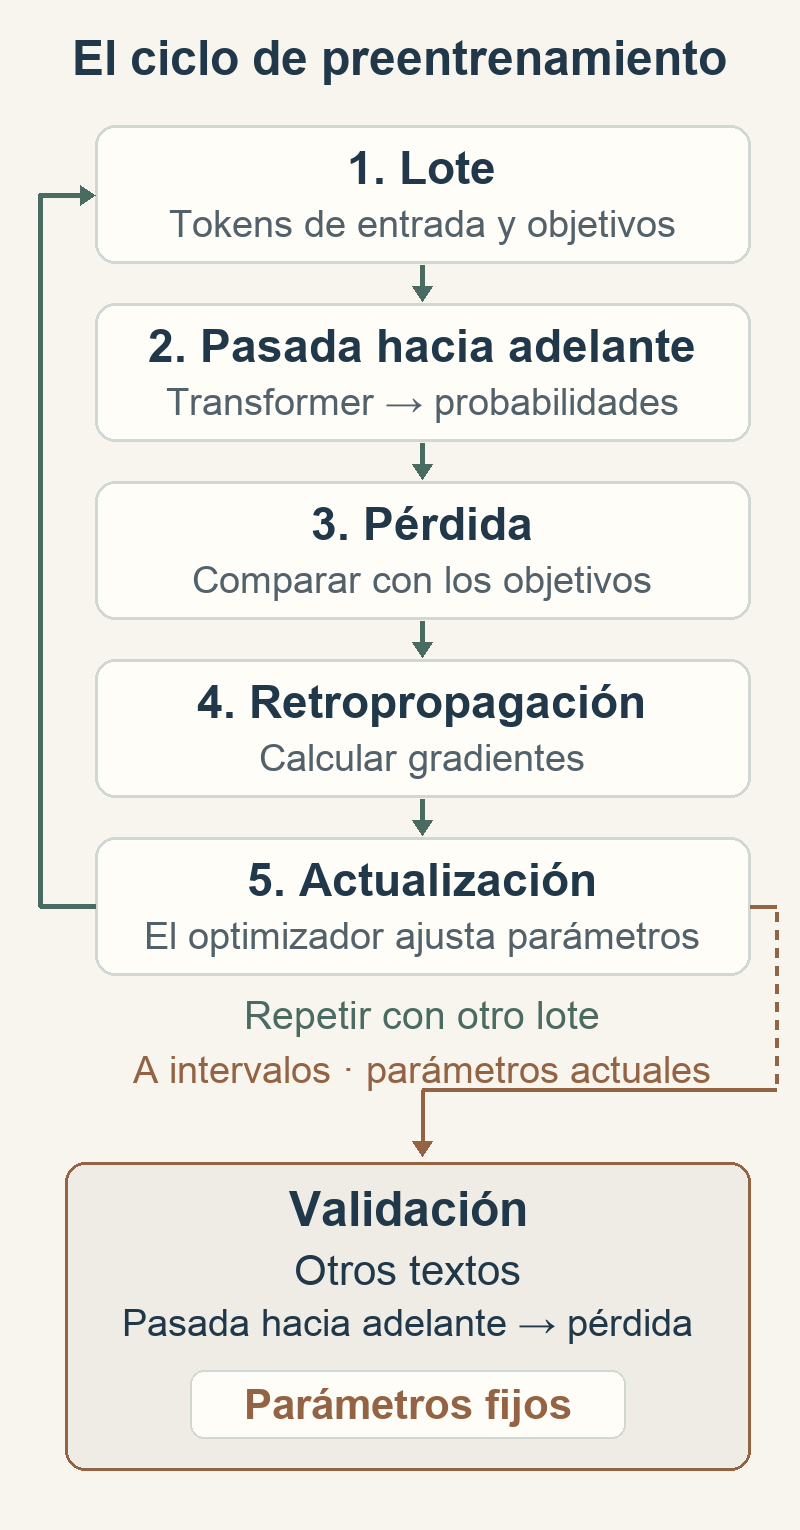
El ciclo de entrenamiento cambia los parámetros. A intervalos, una pasada de validación aparte mide la pérdida sobre otros textos con esos parámetros fijos.
Llamamos preentrenamiento a esta etapa de aprendizaje general que puede servir de base para usos y ajustes posteriores. La tarea de anticipar tokens se repite sobre textos variados; para reducir su pérdida, la red puede aprender regularidades útiles en muchos contextos. Que una regularidad aparezca, se memorice o se aplique bien a un caso nuevo es algo que tendremos que comprobar.
A intervalos se guardan puntos de control, o checkpoints. Para ejecutar el modelo interesan su configuración y los parámetros aprendidos, junto con el tokenizador correspondiente. Para reanudar el entrenamiento fielmente hace falta conservar más estado, incluido el del optimizador. La arquitectura describe las operaciones; los parámetros guardados reflejan el recorrido de entrenamiento que ya se hizo.
Qué crece cuando crece un LLM
Ahora imaginemos ampliar ese trabajo. Podemos aumentar el número de parámetros, presentar más tokens o invertir más cómputo. Las tres decisiones están relacionadas: una red mayor cuesta más por paso, y procesar más texto requiere más operaciones. Añadir parámetros también deja más valores por ajustar con los ejemplos disponibles.
El estudio conocido como Chinchilla examinó cómo repartir un presupuesto de cómputo entre tamaño y cantidad de entrenamiento. Su modelo de 70 mil millones de parámetros procesó 1.4 billones de tokens; Gopher, de 280 mil millones de parámetros, había procesado 300 mil millones. El presupuesto de cómputo fue aproximadamente el mismo (Hoffmann et al., 2022, tabla 1 (se abre en una pestaña nueva)).
Veamos una comparación concreta: en MMLU, un conjunto de preguntas de 57 materias académicas, la evaluación 5-shot —con cinco ejemplos en el contexto— dio una precisión media de 67.6 % para Chinchilla frente a 60.0 % para Gopher, una diferencia de 7.6 puntos porcentuales. Chinchilla mejoró en 51 tareas, empató en dos y empeoró en cuatro (Hoffmann et al., 2022, sección 4.2 (se abre en una pestaña nueva); tablas A8–A9 del suplemento (se abre en una pestaña nueva)). La comparación mostró que Gopher estaba subentrenado para su presupuesto de cómputo: un modelo menor, entrenado con más tokens, aprovechaba mejor aproximadamente el mismo cómputo.
Ese equilibrio cambia si también contamos el costo de utilizar el modelo. El análisis de Sardana et al. (2024) (se abre en una pestaña nueva) muestra que, con suficiente demanda de inferencia, puede convenir entrenar durante más tiempo un modelo menor: el trabajo adicional de entrenamiento se compensa al servir las consultas. Sus autores señalan los 15 billones de tokens usados para Llama 3 como un ejemplo de entrenamiento muy por encima del criterio de Chinchilla centrado solo en entrenar. El objetivo económico incluye ahora el uso posterior.
Además, contar tokens procesados no indica cuántos eran distintos: recorrer diez veces el mismo material suma trabajo sin incorporar diez colecciones nuevas. Ahí vuelven a importar las repeticiones y la mezcla de fuentes que estudiamos al preparar los datos.
En nuestro caso sería fácil aumentar la cuenta copiando la frase del pescador. Más difícil, y más interesante, sería reunir otros usos del lenguaje que nos permitan comprobar qué relaciones consigue aprender.
La mejora tiene que salir del cuaderno de práctica
Podemos observar cómo baja la pérdida sobre los lotes de entrenamiento. Pero queremos saber qué ocurre con textos que no utilizamos para ajustar los pesos. Por eso calculamos también la pérdida sobre material de validación, ejecutando el modelo sin actualizar sus parámetros con esos ejemplos.
El cuaderno de práctica y los textos reservados cumplen funciones distintas. La validación mide la pérdida con los parámetros fijos. Acuarela conceptual.
Supongamos que mejora mucho al completar «El pescador reparó su red» y apenas mejora ante frases nuevas. Eso nos daría motivos para investigar sobreajuste: una adaptación a las particularidades del entrenamiento que no se extiende como esperábamos. Habría que revisar también si la validación representa otra distribución. Distinguir esas causas exige examinar los textos y las condiciones de evaluación junto con las curvas.
En lenguaje se utiliza además la perplejidad, una transformación de la pérdida media. Con el mismo tokenizador, textos y procedimiento, una perplejidad menor indica que el modelo asignó mayor probabilidad a las continuaciones observadas. La nota 3 explica la relación. Esa medida no equivale al porcentaje de respuestas correctas ni demuestra que el modelo sea un buen asistente.
Volvamos a una decisión concreta. Si queremos usarlo para responder preguntas sobre pesca, completar bien las frases de un manual aporta evidencia sobre una capacidad limitada. También necesitaremos preguntas y criterios que permitan comprobar si las respuestas son correctas y útiles. El objetivo de entrenamiento nos dice qué se optimizó; la evaluación del uso nos dice hasta dónde llegó ese aprendizaje.
Cuando quitamos la palabra de verdad
Al terminar el preentrenamiento tenemos un modelo base con parámetros ajustados. Podemos volver a escribir «El pescador reparó su» y calcular una distribución con esos valores. Esta vez no hay un token de referencia esperando para medir la pérdida: queremos obtener una continuación.
En esa inferencia habitual, los parámetros permanecen fijos. Elegimos un token mediante una regla de selección, lo añadimos a la entrada y calculamos la siguiente distribución. Esa es la diferencia respecto al teacher forcing: después del texto inicial, el contexto incorpora las continuaciones que acabamos de generar. El texto disponible cambia y con él cambian las representaciones internas, aunque no haya una actualización de pesos. Entrenar modificaba el mecanismo; ahora lo estamos utilizando.
Todavía hay distancia entre continuar un texto y responder bien a una solicitud. El trabajo de InstructGPT, por ejemplo, estudió ajustes posteriores con demostraciones y preferencias humanas para orientar ese comportamiento (Ouyang et al., 2022 (se abre en una pestaña nueva)). Esa será otra pregunta del recorrido. Antes seguiremos cómo la distribución se convierte, token a token, en una respuesta.
La frase del principio sigue cabiendo en una línea. Ahora podemos reconocer lo que ocurrió alrededor: el texto aportó las referencias, la arquitectura calculó predicciones, el objetivo midió una diferencia y el optimizador ajustó parámetros. El LLM que hemos seguido es, al final, un Transformer de solo decodificador cuyos parámetros resultan de repetir ese ciclo sobre muchos textos. Con esos parámetros calcula probabilidades para continuar una secuencia. Cuando aparezca «red» en la pantalla, veremos una palabra; detrás de su probabilidad habrá una historia de ejemplos y pequeños cambios que ya sabemos empezar a reconstruir.
Notas
-
De la probabilidad a la pérdida. Para un token objetivo , con probabilidad dado el prefijo , usamos . El símbolo reúne los parámetros. Así, y . Para una secuencia con , si puntuamos desde el segundo token y damos el mismo peso a cada posición:
El denominador cuenta las posiciones evaluadas. Con un token de inicio podríamos puntuar también la primera. En un lote, el promedio debe respetar las posiciones válidas y los pesos elegidos. En este caso sin suavizado de etiquetas, minimizar la entropía cruzada equivale a maximizar la log-verosimilitud de las continuaciones observadas (Goodfellow et al., 2016, sección 6.2.1.1 (se abre en una pestaña nueva); PyTorch contributors, s. f. (se abre en una pestaña nueva)). Volver a la comparación.
-
Un peso que sí podemos seguir. Aislamos un peso que conecta una activación fija con el logit de «red»: , donde reúne las demás contribuciones, que mantendremos fijas. Tomamos y elegimos esas contribuciones y los demás logits de modo que la probabilidad inicial sea . Para softmax y la pérdida del objetivo «red», . Por la regla de la cadena:
Con tasa de aprendizaje , un paso de descenso de gradiente da:
El logit aumenta . Manteniendo fijos los otros logits y todas las activaciones, la nueva probabilidad es:
Es un cálculo didáctico con un único peso libre, sin regularización ni parámetros compartidos adicionales. Una actualización real reúne gradientes de muchas posiciones y puede modificar muchas probabilidades a la vez; no garantiza mejorar cada ejemplo. El gradiente de softmax se corresponde, con signo opuesto al maximizar log-verosimilitud, con el cálculo de Bengio et al. (2003, pp. 1145–1146) (se abre en una pestaña nueva). Volver al ajuste.
-
Qué expresa la perplejidad. Si es la pérdida media por token calculada con logaritmos naturales, la perplejidad es . Por ejemplo, corresponde a una perplejidad de 4. Equivale a la inversa de la media geométrica de las probabilidades asignadas a los tokens observados; no significa que hubiera exactamente cuatro candidatos en cada posición. Bengio et al. (2003, p. 1141) (se abre en una pestaña nueva) describen esta medida para reportar sus resultados de modelado de lenguaje. Cambiar el tokenizador cambia la unidad del promedio; el informe de GPT-2 discute esta dificultad de comparación (Radford et al., 2019, sección 3.1 (se abre en una pestaña nueva)). Volver a la validación.
Referencias
Bengio, Y., Ducharme, R., & Vincent, P. (2000). A neural probabilistic language model. En T. K. Leen, T. G. Dietterich, & V. Tresp (Eds.), Advances in Neural Information Processing Systems (Vol. 13, pp. 932–938). MIT Press. Actas del congreso (se abre en una pestaña nueva)
Bengio, Y., Ducharme, R., Vincent, P., & Jauvin, C. (2003). A neural probabilistic language model. Journal of Machine Learning Research, 3, 1137–1155. Artículo original (se abre en una pestaña nueva)
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press. Libro completo (se abre en una pestaña nueva)
Hoffmann, J., Borgeaud, S., Mensch, A., Buchatskaya, E., Cai, T., Rutherford, E., de Las Casas, D., Hendricks, L. A., Welbl, J., Clark, A., Hennigan, T., Noland, E., Millican, K., van den Driessche, G., Damoc, B., Guy, A., Osindero, S., Simonyan, K., Elsen, E., . . . Sifre, L. (2022). An empirical analysis of compute-optimal large language model training. En S. Koyejo, S. Mohamed, A. Agarwal, D. Belgrave, K. Cho, & A. Oh (Eds.), Advances in Neural Information Processing Systems (Vol. 35, pp. 30016–30030). Curran Associates. Actas del congreso (se abre en una pestaña nueva) DOI (se abre en una pestaña nueva)
Kingma, D. P., & Ba, J. (2015). Adam: A method for stochastic optimization [Ponencia]. 3rd International Conference on Learning Representations, San Diego, CA, Estados Unidos. Manuscrito de los autores (se abre en una pestaña nueva)
Ouyang, L., Wu, J., Jiang, X., Almeida, D., Wainwright, C. L., Mishkin, P., Zhang, C., Agarwal, S., Slama, K., Ray, A., Schulman, J., Hilton, J., Kelton, F., Miller, L., Simens, M., Askell, A., Welinder, P., Christiano, P. F., Leike, J., & Lowe, R. (2022). Training language models to follow instructions with human feedback. En S. Koyejo, S. Mohamed, A. Agarwal, D. Belgrave, K. Cho, & A. Oh (Eds.), Advances in Neural Information Processing Systems (Vol. 35, pp. 27730–27744). Curran Associates. Actas del congreso (se abre en una pestaña nueva) DOI (se abre en una pestaña nueva)
PyTorch contributors. (s. f.). CrossEntropyLoss. PyTorch 2.9 documentation. Recuperado el 4 de octubre de 2026 de la documentación del proyecto (se abre en una pestaña nueva).
Radford, A., Wu, J., Child, R., Luan, D., Amodei, D., & Sutskever, I. (2019). Language models are unsupervised multitask learners [Informe técnico]. OpenAI. Informe original (se abre en una pestaña nueva)
Sardana, N., Portes, J., Doubov, S., & Frankle, J. (2024). Beyond Chinchilla-optimal: Accounting for inference in language model scaling laws. En R. Salakhutdinov, Z. Kolter, K. Heller, A. Weller, N. Oliver, J. Scarlett, & F. Berkenkamp (Eds.), Proceedings of the 41st International Conference on Machine Learning (Vol. 235, pp. 43445–43460). PMLR. Actas del congreso (se abre en una pestaña nueva)
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. En I. Guyon, U. von Luxburg, S. Bengio, H. Wallach, R. Fergus, S. V. N. Vishwanathan, & R. Garnett (Eds.), Advances in Neural Information Processing Systems (Vol. 30). Curran Associates. Actas del congreso (se abre en una pestaña nueva)
Personas mencionadas
Yoshua Bengio
Investigador en aprendizaje profundo y modelos neuronales del lenguaje. Con Dzmitry Bahdanau y Kyunghyun Cho fue coautor del trabajo de traducción que presentó un mecanismo de atención influyente anterior al Transformer.
Fuentes