IA explicada
¿Qué es un Transformer?
Acompaña al pescador desde una frase en inglés hasta su traducción y descubre cómo un Transformer relaciona información para construir una salida, sin necesitar fórmulas.
Artículo 5 de 5 · Orden de lectura
Imagina que tienes que traducir esta frase: «The fisherman repaired his net beside the bank». Si has seguido la serie, ya conoces al pescador que repara su red junto a la orilla. La palabra inglesa bank nos ayudó a ver por qué necesitamos contexto. Ahora vamos a acompañarla hasta que aparezca una traducción.
Una escena, varias transformaciones. El pescador nos acompañará durante todo el recorrido.
La dificultad va más allá de elegir «orilla» en un diccionario. Hay que conservar quién repara qué, relacionar el lugar con la escena y construir una frase en otro idioma. En el artículo sobre atención vimos cómo una posición reúne información de otras. Quedó pendiente algo: cómo organizar una red que use esa información para producir una salida.
Un Transformer es una forma de organizar una red neuronal alrededor de la atención. Podemos imaginar el recorrido completo antes de abrir sus piezas: preparar la frase, relacionar sus partes y utilizar lo obtenido para construir una respuesta. En el diseño original, dos módulos se reparten ese trabajo: el encoder procesa la entrada y el decoder consulta ese resultado para construir la salida.
La propuesta de 2017 prescindió del procesamiento recurrente, que actualiza un estado posición por posición. La atención permitía conectar directamente posiciones distantes y calcular muchas operaciones de una capa en paralelo. Vaswani y sus colegas evaluaron el diseño principalmente en traducción (Vaswani et al., 2017 (se abre en una pestaña nueva)). Nuestra frase permite ver cómo funciona esa organización. Basta con seguir qué información está disponible en cada momento; los números pueden esperar.
Primero, preparar la frase
La computadora empieza dividiendo el texto en tokens, unidades que pueden ser palabras, fragmentos o signos. Después asigna a cada uno una lista de números: su representación inicial, o embedding. Es el paso que exploramos en De palabras a vectores. Aquí usaremos las palabras como etiquetas para seguir el ejemplo, aunque un tokenizador real podría dividirlas de otra manera.
Hasta aquí, hemos asignado números a cada token. También necesitamos indicar en qué orden aparecen en la frase: «El pescador encontró a la cajera» y «La cajera encontró al pescador» contienen casi las mismas piezas, pero cambian quién encuentra a quién. La representación inicial de cada token debe incorporar su lugar en la secuencia para que el modelo pueda utilizar esa diferencia.
El Transformer original añade una señal de posición a la representación de cada token. Así, el punto de partida combina información sobre el token y sobre el lugar que ocupa. Podemos imaginar unas tarjetas colocadas en una mesa, cada una con una marca de posición. En el modelo, tanto el contenido como esa marca se expresan mediante números; la nota 1 explica el detalle.
Ya tenemos preparada la entrada. bank ocupa un lugar al final de nuestra frase, pero su representación inicial todavía necesita incorporar lo que ocurre alrededor. Ahí empieza el trabajo del encoder.
Relacionar las piezas y trabajar sobre lo reunido
Pensemos en lo que hacemos al leer. Si encontramos bank aislado, quedan abiertas varias interpretaciones. Al añadir un pescador, su red y la acción de repararla, la orilla encaja en la escena. El modelo dispone de un mecanismo para combinar información de esas posiciones: la autoatención que conocimos en la entrega anterior.
En nuestro ejemplo, la representación de bank puede recibir aportaciones de fisherman y net. La atención multicabeza hace varias mezclas de información en paralelo y combina sus resultados. Esas mezclas se calculan con parámetros aprendidos durante el entrenamiento. El recorrido que imaginamos sirve para explicar el mecanismo; saber qué relaciones utiliza un modelo concreto requiere examinarlo.
La atención ha reunido pistas de otras posiciones en la representación de bank. Después, una pequeña red neuronal, llamada feedforward, vuelve a combinar sus números. Puede reforzar ciertas combinaciones de rasgos y atenuar otras, según sus parámetros aprendidos, preparando una actualización que las siguientes capas puedan aprovechar. La atención intercambia información entre posiciones; la feedforward trabaja sobre lo reunido en cada una.
Al aplicar estas transformaciones, las conexiones residuales mantienen una vía directa para la representación que entra y le suman la actualización. En bank, esto permite que lo que ya había llegue a la suma junto con la nueva información. La normalización ajusta la escala de los números y ayuda a mantener estable el entrenamiento al repetir el proceso en muchas capas. La nota 2 muestra cómo encajan ambas operaciones y permite consultar sus cálculos.
Este conjunto forma un bloque. El siguiente recibe las representaciones que dejó el anterior y vuelve a trabajar sobre ellas. Por eso bank puede incorporar nuevas relaciones a partir de información que ya pasó por otras transformaciones. Cada bloque tiene sus propios parámetros aprendidos, aunque repita la misma estructura.
Aquí conviene detenerse un momento: seguimos teniendo una representación por posición de la entrada. El encoder ha preparado información que el decoder podrá consultar. La traducción se construye en la siguiente parte del recorrido (Vaswani et al., 2017 (se abre en una pestaña nueva), sección 3.1 (se abre en una pestaña nueva)).
Construir la traducción, un paso a la vez
Supongamos que la salida ya dice: «El pescador reparó su red junto a la…». El decoder necesita continuar desde ahí. Cuenta con dos fuentes: lo que lleva escrito en español y la información que el encoder preparó a partir de la frase inglesa.
Primero relaciona las partes de la traducción disponible mediante atención. Aquí vuelve la máscara causal de la entrega anterior: cada posición puede consultar su propio token y los anteriores, mientras que las posiciones posteriores quedan bloqueadas. Al continuar desde «la», ese token también forma parte del contexto. La restricción afecta a la salida; la frase inglesa completa sigue disponible.
Después entra la atención cruzada, que también presentamos al hablar de traducción. Conecta ambos lados del recorrido. Desde la posición de «la», el decoder utiliza lo que lleva escrito para consultar la información del encoder. En nuestra escena, esa consulta puede recibir una aportación importante de bank, cuya representación ya tuvo oportunidades de incorporar contexto del pescador y su red.
Puedes seguir ese encuentro en la animación. Las líneas muestran cómo se reparte el peso de atención entre las posiciones en un ejemplo inventado. Lo importante ahora es ver cómo se conectan la frase original y la traducción incompleta. Si te da curiosidad hacer la cuenta, abre «Ver los números».
El movimiento está pausado. Usa los botones para explorar cada paso.
Frase original · inglés
- The
- fisherman
- repaired
- his
- net
- beside
- the
- bank
Traducción hasta ahora · español
El pescador reparó su red junto a la
Punto de continuación
- 1. Usar lo que llevamos escritoEn «la», el modelo dispone de la traducción escrita hasta ahora como contexto. Esto ayuda a determinar qué información recoger de la frase original.
- 2. Consultar la frase originalLa frase original aporta información a esta posición. En nuestro ejemplo, la mayor contribución procede de «bank», cuya representación ya incorpora contexto.
- 3. Reunir información para continuarLas aportaciones se combinan y pasan por otras transformaciones. Después, el modelo asigna probabilidades a los tokens que podrían seguir.
Ver los números
La consulta procede de la representación en «la» y se compara con las claves del encoder. Estos pesos inventados para una cabeza suman 1. Cada uno multiplica un vector de valor; la suma es la aportación que continúa el recorrido, no una probabilidad del siguiente token. Las posiciones de entrada pueden procesarse en paralelo.
The0.02 × [0, 0]
fisherman0.10 × [1, 0]
repaired0.02 × [0, 0]
his0.02 × [0, 0]
net0.20 × [0, 2]
beside0.02 × [0, 0]
the0.02 × [0, 0]
bank0.60 × [2, 1]
0.60[2,1] + 0.20[0,2] + 0.10[1,0] + 0.10[0,0] = [1.3,1.0]
Un ejemplo inventado: un modelo entrenado puede repartir la atención de otra manera.
La información recogida continúa por las transformaciones del decoder. Al final, el modelo asigna probabilidades a los tokens que podrían seguir. En nuestro ejemplo, «orilla» podría recibir una probabilidad mayor que «banco» o «casa» y ser elegida como continuación. Una palabra puede necesitar varios tokens, y nada garantiza que la elección sea correcta.
En este tramo hay dos operaciones distintas. Los pesos de atención indican cuánto se pondera la información de cada posición; su aportación a la mezcla depende también de los valores que se combinan. Las probabilidades finales permiten elegir qué token añadir a la salida. Una línea más gruesa hacia bank no es una probabilidad de escribir «orilla».
El token elegido se incorpora al texto y el proceso continúa. Ahora el decoder dispone de una traducción un poco más larga para producir el siguiente token, hasta llegar a una condición de parada. Podemos calcular muchas operaciones internas en paralelo y, aun así, generar la continuación paso a paso. La nota 3 amplía esa diferencia.
La frase original permanece disponible mientras la traducción crece. Ilustración conceptual.
Del traductor a los modelos que continúan texto
Hasta aquí usamos las dos partes del Transformer original. Otras arquitecturas aprovechan piezas emparentadas con una organización distinta. Reconocerlas ayuda a conectar nuestra traducción con otros usos del lenguaje.
Un modelo solo encoder, como BERT, utiliza el contexto de ambos lados de una posición para construir representaciones. Estas pueden servir, por ejemplo, para clasificar un texto o localizar una respuesta dentro de un pasaje (Devlin et al., 2019 (se abre en una pestaña nueva)).
Un modelo solo decoder, como GPT-2, trabaja con la secuencia disponible para predecir el siguiente token. El texto recibido y la continuación comparten un mismo recorrido, con atención causal. En ese diseño no hay un encoder separado al que consultar mediante atención cruzada (Radford et al., 2019 (se abre en una pestaña nueva)).
Esta segunda organización permite situar la idea de continuar un texto que encontramos en los modelos conversacionales. Entrenarlo para seguir instrucciones y construir una aplicación de chat añade otras decisiones. Por ahora, podemos reconocer el mecanismo básico: utilizar el contexto disponible para proponer una continuación y repetir el proceso.
Volver al pescador
Al principio teníamos una palabra ambigua al final de una frase. Ahora podemos seguir su recorrido: la posición ayuda a conservar el orden; la atención incorpora contexto; las capas transforman lo reunido; y el decoder combina la entrada con lo que ya lleva escrito para continuar la traducción.
Al volver a «orilla», ya podemos reconocer cómo se encontraron las pistas del pescador, el orden de la frase y la traducción incompleta. Esa es la imagen que vale la pena llevarse: información que se relaciona y se transforma, hasta participar en la elección de lo que viene después.
La arquitectura ofrece esas operaciones. El entrenamiento ajusta los parámetros que hacen útil su combinación. Por eso dibujar las conexiones todavía deja abierta una pregunta importante: qué aprenderá el modelo de los ejemplos que reciba. Ese será el siguiente tramo de la serie.
Para explorar estas piezas por tu cuenta, te propongo tres recorridos breves:
-
Seguir una consulta en The Transformer, Drawn (se abre en una pestaña nueva). En la herramienta que creé, conserva la frase de ejemplo y abre «05 Scores». En «Query token», selecciona primero la primera palabra y luego la última: observa cómo cambia el conjunto de posiciones disponibles. La primera solo puede consultarse a sí misma; la última puede consultar también todas las anteriores. Pasa a «06 Softmax» y «07 Values» para seguir el paso de puntuaciones a pesos y de pesos a una mezcla de valores. Es una simulación con números inventados: omite residuales y normalización, y simplifica feedforward. Puedes inspeccionar esas decisiones en el código en GitHub (se abre en una pestaña nueva).
-
Ubicar el recorrido completo con The Illustrated Transformer (se abre en una pestaña nueva), de Alammar (2018). Empieza por el esquema general que separa encoder y decoder. Después busca «The Residuals»: sigue las flechas que rodean cada transformación y localiza la normalización. Ahí aparecen las piezas que mi simulación omite. Continúa con «The Decoder Side» y sigue las conexiones desde el encoder hasta la atención del decoder. Puedes relacionarlas con nuestra consulta desde «la» a la frase inglesa; el dibujo ayuda a ver dónde ocurre ese encuentro dentro de la arquitectura.
-
Probar una continuación con Transformer Explainer (se abre en una pestaña nueva). Este recurso ejecuta GPT-2 en el navegador (Cho et al., 2026 (se abre en una pestaña nueva)). Mientras carga el modelo, puedes explorar las frases de «Examples». Cuando esté listo, escribe «The fisherman repaired his net beside the» y pulsa «Generate». Aquí observarás cómo continúa la frase en inglés. Mira los candidatos en «Probabilities» y qué token se añade. Luego vuelve a dejar el mismo prefijo y cambia solo «Temperature», manteniendo los ajustes de muestreo: al bajarla, la distribución se concentra más en los candidatos con mayor puntuación; al subirla, se reparte más. El ejercicio permite distinguir las probabilidades disponibles del token que finalmente se selecciona.
Notas: ampliación técnica opcional
Estas notas opcionales reúnen los detalles matemáticos y las variantes. El recorrido principal puede leerse completo sin abrirlas.
-
Orden y señales de posición. En una autoatención sin información posicional y sin una máscara que distinga posiciones, permutar las filas de entrada permuta las filas de salida del mismo modo: la operación es equivariante a esa permutación, no invariante. Las señales de posición rompen esa simetría. Los senos y cosenos del Transformer original tienen frecuencias diferentes entre pares de coordenadas; el trabajo también compara posiciones aprendidas (Vaswani et al., 2017 (se abre en una pestaña nueva), sección 3.5 (se abre en una pestaña nueva)). Una máscara causal introduce una asimetría: las posiciones posteriores pueden acceder a más predecesores. Haviv y sus colegas observaron que modelos de lenguaje causales sin codificación posicional explícita pueden aprender información de posición; proponen que ese patrón de acceso ayuda a explicarlo (Haviv et al., 2022 (se abre en una pestaña nueva)). Por eso el argumento de la atención sin máscara no se puede trasladar sin más al caso causal. Volver a las posiciones.
-
Las coordenadas que normalizamos. Para un vector de coordenadas en una posición, y . Entonces . La constante estabiliza la división; y son parámetros aprendidos, compartidos entre posiciones en esa normalización. Para un ejemplo pequeño, usemos escala uno y desplazamiento cero. Con esos valores y omitiendo para la cuenta, , y se convierten en : bastan dos coordenadas para ver la pérdida de escala. Con un positivo pequeño, esos resultados son aproximados; sumar la misma constante a ambas coordenadas de entrada sigue dejando el resultado intacto. Normalizar no conserva toda la información del vector de forma invertible, y la transformación aprendida hace que la salida no tenga necesariamente media cero y varianza uno (Ba et al., 2016 (se abre en una pestaña nueva)).
El bloque del encoder original puede escribirse como e . Aquí, reúne las representaciones de entrada, es el resultado intermedio e es la salida; cada fila representa una posición. La red feedforward aplica dos transformaciones aprendidas con una activación ReLU entre ambas; sus parámetros se comparten entre posiciones dentro de un bloque. La operación de atención incluye su proyección de salida, y estas expresiones omiten dropout (Vaswani et al., 2017 (se abre en una pestaña nueva), secciones 3.1–3.3 (se abre en una pestaña nueva)).
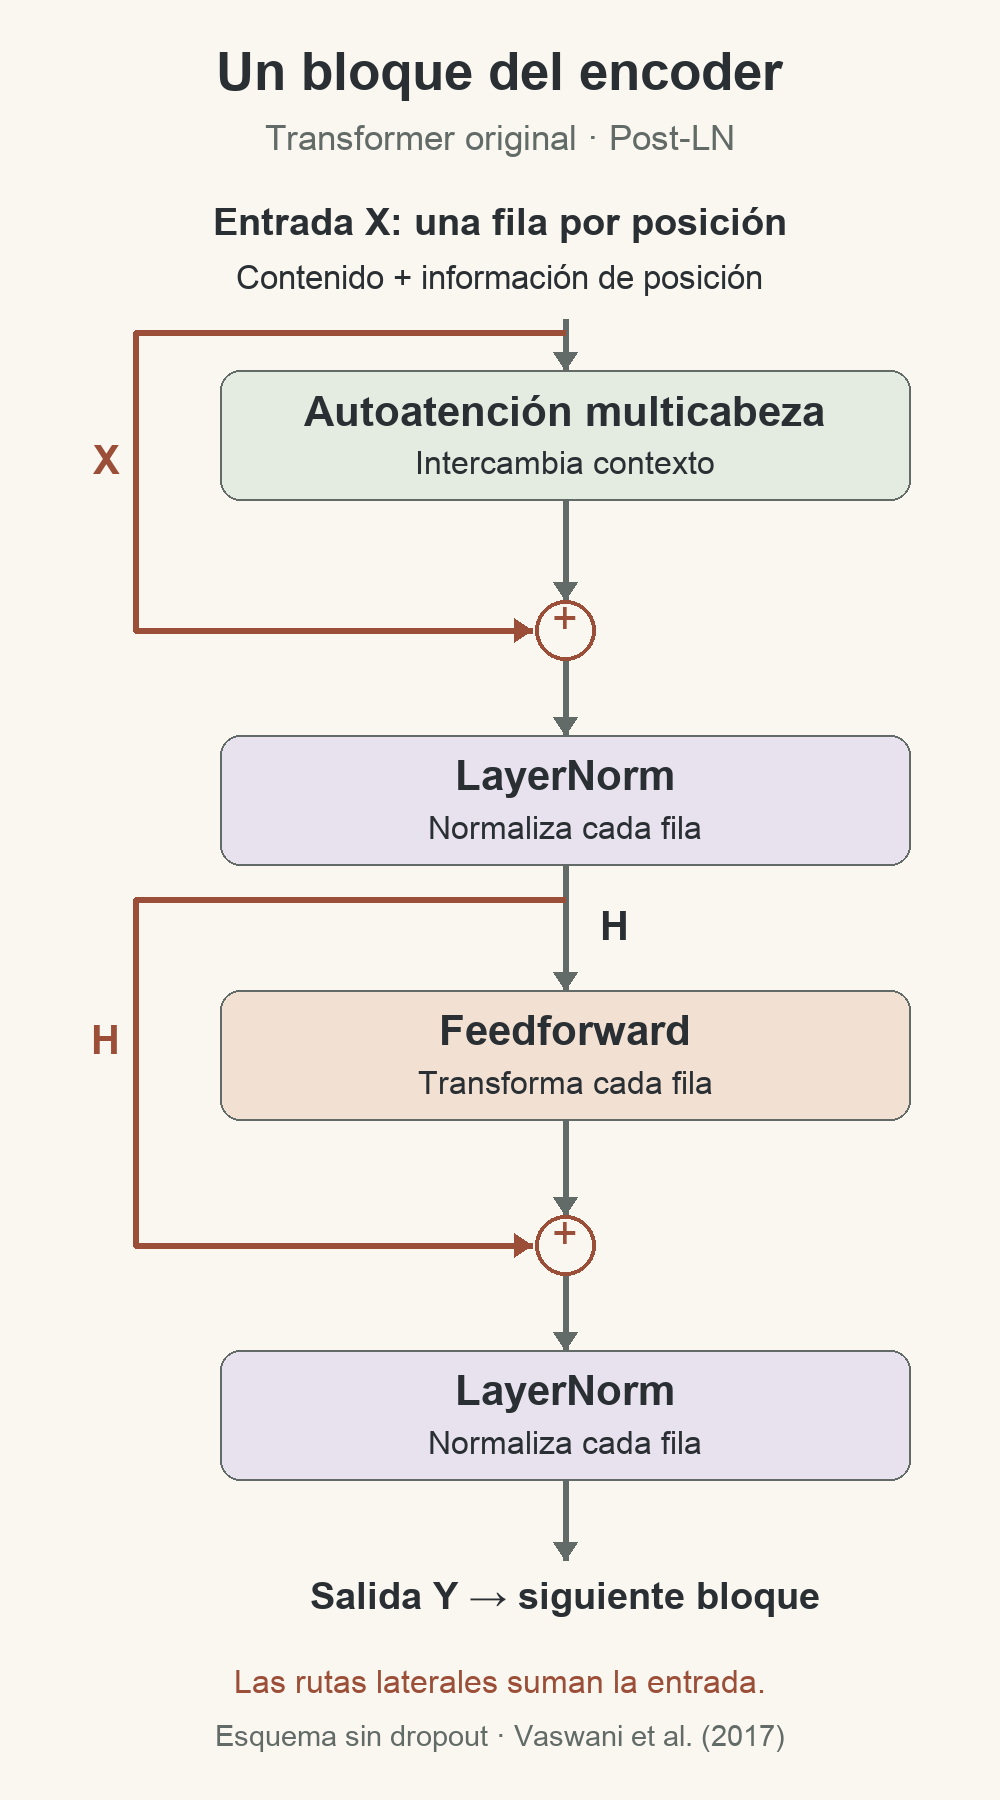
Las rutas laterales muestran las conexiones residuales. El esquema sigue el orden Post-LN del encoder original y omite dropout.
Otras variantes colocan la normalización antes de la atención y la feedforward, dentro de las ramas residuales. Esta organización Pre-LN cambia el comportamiento de los gradientes y las condiciones de entrenamiento (Xiong et al., 2020 (se abre en una pestaña nueva)). El diagrama muestra un diseño concreto. Volver al bloque.
-
La referencia como entrada durante el entrenamiento. Alimentar el decoder con el prefijo correcto, en vez de con sus propias elecciones anteriores, se conoce como teacher forcing. La entrada se desplaza para que cada posición prediga el token siguiente; la máscara impide consultar las posiciones posteriores. Los errores de esas predicciones contribuyen a una pérdida y sus gradientes ajustan los parámetros. Durante la generación habitual, el prefijo se amplía con los tokens que se van seleccionando, sin disponer de la continuación de referencia (Vaswani et al., 2017 (se abre en una pestaña nueva), sección 3.1 (se abre en una pestaña nueva)). En la autoatención densa, comparar cada consulta con cada clave produce una tabla de entradas para posiciones. Duplicar la longitud de la secuencia cuadruplica ese recuento; no es una medida directa de latencia o memoria para cualquier implementación. Volver a la traducción.
Referencias
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention Is All You Need (se abre en una pestaña nueva). En I. Guyon, U. von Luxburg, S. Bengio, H. Wallach, R. Fergus, S. Vishwanathan, & R. Garnett (Eds.), Advances in Neural Information Processing Systems (Vol. 30, pp. 5998–6008). Curran Associates.
Alammar, J. (2018, 27 de junio). The illustrated Transformer. Artículo ilustrado (se abre en una pestaña nueva)
Ba, J. L., Kiros, J. R., & Hinton, G. E. (2016). Layer normalization [Prepublicación]. arXiv. https://doi.org/10.48550/arXiv.1607.06450 (se abre en una pestaña nueva)
Cho, A., Kim, G. C., Karpekov, A., Lee, S., Helbling, A., Hoover, B., Wang, Z. J., Kahng, M., & Chau, D. H. (2026). Transformer Explainer: Learning LLM Transformers with interactive visual explanation and experimentation. En Proceedings of the 2026 CHI Conference on Human Factors in Computing Systems (pp. 1–21). ACM. https://doi.org/10.1145/3772318.3791725 (se abre en una pestaña nueva)
Devlin, J., Chang, M.-W., Lee, K., & Toutanova, K. (2019). BERT: Pre-training of deep bidirectional Transformers for language understanding. En J. Burstein, C. Doran, & T. Solorio (Eds.), Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 1 (Long and Short Papers) (pp. 4171–4186). Association for Computational Linguistics. https://doi.org/10.18653/v1/N19-1423 (se abre en una pestaña nueva)
Haviv, A., Ram, O., Press, O., Izsak, P., & Levy, O. (2022). Transformer language models without positional encodings still learn positional information. En Y. Goldberg, Z. Kozareva, & Y. Zhang (Eds.), Findings of the Association for Computational Linguistics: EMNLP 2022 (pp. 1382–1390). Association for Computational Linguistics. https://doi.org/10.18653/v1/2022.findings-emnlp.99 (se abre en una pestaña nueva)
Radford, A., Wu, J., Child, R., Luan, D., Amodei, D., & Sutskever, I. (2019). Language models are unsupervised multitask learners [Informe técnico]. OpenAI. Informe original (se abre en una pestaña nueva)
Xiong, R., Yang, Y., He, D., Zheng, K., Zheng, S., Xing, C., Zhang, H., Lan, Y., Wang, L., & Liu, T. (2020). On layer normalization in the Transformer architecture. En H. Daumé III & A. Singh (Eds.), Proceedings of the 37th International Conference on Machine Learning (Vol. 119, pp. 10524–10533). PMLR. Actas del congreso (se abre en una pestaña nueva)