IA explicada
De palabras a vectores: tokens, embeddings y por qué el significado se vuelve geometría
Sigue una frase desde los tokens hasta los identificadores y los vectores aprendidos, y descubre por qué aún hace falta el contexto para interpretar una palabra.
Artículo 3 de 5 · Orden de lectura
Imagina que lees esta frase en inglés: «The bank flooded after the storm». Quizás pienses en la orilla de un río desbordado. Quizás imagines el agua entrando por las puertas de una sucursal bancaria. En inglés, bank puede referirse tanto a un banco como a la orilla de un río. La frase nos da pistas, pero admite ambas lecturas. Hasta una palabra familiar necesita compañía para que podamos decidir qué significa aquí.
Una palabra, dos sentidos posibles: una ilustración conceptual del recorrido del lenguaje hacia las representaciones geométricas.
Un modelo de lenguaje tiene un problema previo: ¿cómo se convierte esa frase en algo con lo que una red neuronal pueda calcular? En el artículo anterior, seguimos una red desde su entrada hasta una predicción y vimos cómo los errores orientan el aprendizaje. Esta vez, la entrada es lenguaje. Antes de que una capa pueda trabajar con él, el texto necesita una representación numérica.
Seguir esa transformación nos llevará por tres cosas que es fácil confundir: tokens, identificadores y embeddings. Mantendremos la misma frase en inglés durante el recorrido para poder seguir sus piezas. Cuando volvamos a su ambigüedad, podremos explicar qué aporta cada paso y qué queda todavía por resolver.
Primero, decidir por dónde cortar
Solemos leer la frase como palabras separadas por espacios. Un tokenizador, el componente que prepara el texto para el modelo, trabaja con un vocabulario de piezas llamadas tokens. Una pieza puede ser una palabra completa, parte de una palabra, un signo de puntuación o una secuencia que incluya un espacio.
Supongamos que nuestro tokenizador produce estas piezas. Es un ejemplo inventado, no la salida de un sistema concreto:
[The] [ bank] [ flooded] [ after] [ the] [ storm] [.]
Los espacios dentro de los corchetes son intencionales. Esta convención aparece en tokenizadores como el de GPT-2, cuyo preprocesamiento puede agrupar un espacio inicial con las letras siguientes antes de aplicar BPE a nivel de bytes (OpenAI, 2019 (se abre en una pestaña nueva)). Nuestras piezas e identificadores siguen siendo ilustrativos. Con otro vocabulario, riverbank podría mantenerse completa o dividirse en river y bank. Estos límites reflejan las reglas del tokenizador, más que una clase de gramática.
¿Para qué tomarse esa molestia? Guardar un token por cada palabra posible exigiría contemplar nombres, variantes ortográficas y palabras que todavía no hemos encontrado. Los caracteres ofrecen piezas pequeñas y reutilizables, pero convierten incluso una frase breve en una secuencia más larga. La tokenización en subpalabras busca un punto intermedio: las secuencias frecuentes pueden mantenerse juntas y las palabras menos frecuentes pueden construirse con unidades más pequeñas.
Un método influyente es byte-pair encoding, o BPE —codificación por pares de bytes—. En su adaptación para traducción, parte de caracteres y fusiona repetidamente el par de símbolos adyacentes más frecuente. Las piezas resultantes pueden participar en nuevas fusiones, formando un vocabulario de unidades de longitud variable (Sennrich et al., 2016, sección 3.2 (se abre en una pestaña nueva)). Entrenar el tokenizador permite aprender esas reglas; usarlo consiste en aplicarlas a nuevos textos.
Los tokenizadores toman distintas decisiones sobre sus símbolos iniciales y sus reglas. Decir «subpalabras» no garantiza por sí solo que puedan representar cualquier entrada; la nota 1 explica ese matiz. Para nuestra frase, la consecuencia inmediata es concreta: los límites elegidos determinan cuántas piezas procesará la red y cuáles podrán reutilizar la misma representación inicial.
Un número que indica dónde buscar
Una vez elegidas las piezas, cada una tiene un identificador entero en el vocabulario. Asignemos identificadores inventados a nuestros tokens inventados:
| Token | ID ilustrativo |
|---|---|
The |
104 |
bank |
7312 |
flooded |
29041 |
after |
889 |
the |
262 |
storm |
5774 |
. |
13 |
Fíjate en The y the: la mayúscula y el espacio inicial hacen que sean piezas distintas, por eso nuestro vocabulario les asigna identificadores diferentes. La frase es ahora la secuencia [104, 7312, 29041, 889, 262, 5774, 13]. Ya tenemos números, pero lo que nos dicen es qué piezas se seleccionaron. Restar 7312 de 29041 no revelaría nada sobre la relación entre un banco y una inundación. Los enteros funcionan como direcciones, parecidas a los números de fila de una tabla.
También podríamos expresar cada dirección como un vector one-hot: una lista con un 1 en la posición de ese token y un 0 en todas las demás. Eso distingue cada token. Multiplicar las coordenadas que ocupan la misma posición y sumar los resultados —el producto escalar— da cero para cualquier par de vectores one-hot distintos. Geométricamente, son perpendiculares u ortogonales. La representación por sí misma no nos da grados de similitud. Un modelo puede aprender a partir de esas entradas; necesita parámetros aprendidos para establecer relaciones útiles entre ellas. La conexión con la consulta a la tabla que haremos enseguida está en la nota 2.
La dirección nos permite recuperar la información aprendida que está asociada a ese token.
La fila detrás de la dirección
Imagina una tabla con una fila por token y la misma cantidad de columnas numéricas en cada fila. Esa es la tabla de embeddings. El identificador selecciona una fila, y la fila proporciona un vector: una lista ordenada de valores con los que la red puede trabajar.
Supongamos, para ilustrarlo, que la fila de la dirección 7312 contiene solo tres valores:
Consultar bank recupera esa lista. No hemos calculado los tres valores a partir de los dígitos de 7312; estaban guardados en la fila seleccionada. Tanto el identificador como los valores son inventados. Usamos tres dimensiones para que el ejemplo se pueda leer, mientras que un modelo real puede utilizar cientos o miles.
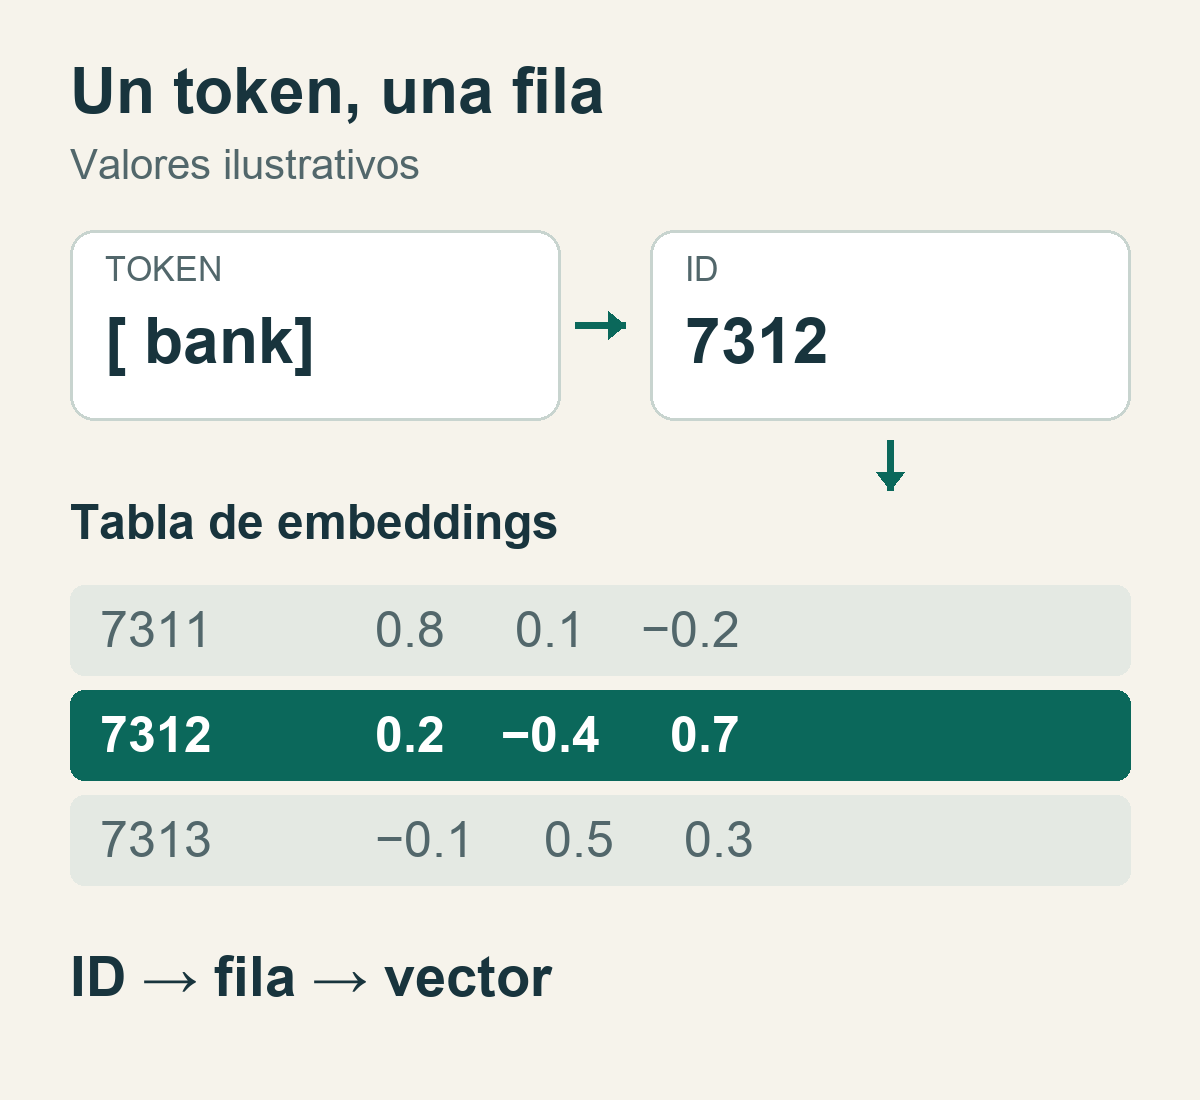
Una consulta ilustrativa: el identificador selecciona una fila y la fila proporciona el vector. Son valores inventados, no mediciones de un modelo entrenado.
Si el vocabulario contiene tokens y cada vector tiene valores, la tabla completa es una matriz . Para el token situado en la posición de la frase, cuyo identificador es , la operación es:
Al aplicarla a cada identificador obtenemos un vector por token, conservando el orden de la frase. Nuestro ejemplo de siete tokens produce siete filas. En general, una secuencia de tokens se convierte en una matriz . Cada es una fila de . Este es nuestro punto de partida numérico. El Transformer original, una arquitectura de red neuronal que usa atención para combinar información entre posiciones, escala los embeddings y suma información de posición antes de su primera capa de procesamiento (Vaswani et al., 2017 (se abre en una pestaña nueva), secciones 3.4–3.5 (se abre en una pestaña nueva)).
Todavía queda una pregunta importante escondida en esa tabla: ¿quién puso allí valores útiles? Desde luego, nadie se sentó a definir cada palabra mediante una lista de decimales.
Cómo el uso deja una huella geométrica
Cuando se entrena un modelo desde cero, la tabla de embeddings suele empezar con valores aleatorios. El entrenamiento ajusta sus parámetros, junto con los del resto de la red, para reducir el error de predicción. Un mismo token puede aparecer en muchos ejemplos, así que su fila recibe señales de aprendizaje de distintos usos. Esos ajustes optimizan la tabla para la tarea de entrenamiento; evaluar el modelo con ejemplos nuevos nos dice qué tan bien generaliza con esa representación.
Aquí reaparece la distinción entre entrenamiento e inferencia del artículo anterior. El entrenamiento modifica la tabla; la inferencia habitual la consulta. Escribir una frase en un modelo entrenado no actualiza, por sí solo, sus parámetros de embeddings. Los vectores calculados después para esa conversación pueden cambiar sin que se reescriba la tabla almacenada.
Dos enfoques anteriores ayudan a concretar la idea del aprendizaje. En 2013, Tomas Mikolov y sus colegas describieron las arquitecturas asociadas a Word2Vec: continuous bag-of-words predice una palabra a partir de las palabras cercanas, mientras que skip-gram predice palabras cercanas a partir de una palabra actual. Aprender esas tareas da a los vectores un motivo para conservar regularidades del uso del lenguaje (Mikolov, Chen, et al., 2013 (se abre en una pestaña nueva)).
GloVe, presentado en 2014 por Jeffrey Pennington, Richard Socher y Christopher Manning, parte de conteos globales de palabras que aparecen cerca unas de otras. Optimiza un objetivo de mínimos cuadrados ponderados: los productos escalares entre vectores, más términos de sesgo, aproximan los logaritmos de los conteos de coocurrencia observados (Pennington et al., 2014, ecuación 8 (se abre en una pestaña nueva)). Los conteos aportan evidencia; un procedimiento de optimización aprende los vectores a partir de ella.
Word2Vec y GloVe pueden producir vectores de palabras reutilizables como resultado principal. Un modelo de lenguaje puede aprender su tabla de embeddings de tokens como parte de una tarea de predicción más amplia. El objetivo cambia, pero una idea útil atraviesa esos casos: los patrones en el uso del lenguaje pueden dejar patrones entre sus representaciones numéricas.
En ese sentido el significado «se vuelve geometría», como dice el título: los patrones de uso se convierten en relaciones que podemos estudiar mediante coordenadas y direcciones. La información se distribuye por el vector, así que interpretar una dimensión exige algo más que asignarle una etiqueta como «financiero» o «río». El espacio refleja el corpus —la colección de textos— y la tarea que le dieron forma.
El uso deja una huella geométrica: una metáfora visual del aprendizaje de representaciones a partir de textos, no un gráfico de embeddings medidos.
Qué nos dice la cercanía y cuáles son sus límites
Una vez que los tokens tienen vectores, podemos compararlos. Una medida habitual es la similitud del coseno, que compara las direcciones de dos vectores distintos de cero:
Dividir el producto escalar entre ambas longitudes elimina la magnitud de esta comparación. Un resultado cercano a 1 indica direcciones muy alineadas; 0, direcciones perpendiculares; y −1, direcciones exactamente opuestas. Retomemos nuestro vector inventado para bank, [0.2, −0.4, 0.7], e inventemos otras dos filas para este cálculo:
river:[0.7, −0.2, 0.2]; coseno conbank≈ 0.574.loan:[−0.3, −0.7, 0.3]; coseno conbank≈ 0.632.
Elegimos estos valores inventados para que bank tenga una similitud del coseno positiva y moderada tanto con river —río— como con loan —préstamo— (traducciones para esta versión). El cálculo deja ambas asociaciones a la vista. No elige un sentido para nuestra frase: eso requerirá contexto. Los números ilustran la operación, en lugar de ser mediciones de un modelo entrenado.
En un espacio aprendido, examinar los vectores cercanos ayuda a explorar qué patrones ha conservado la representación. Los vecinos pueden compartir temas, papeles gramaticales o asociaciones recurrentes; su utilidad depende de la tarea. Un coseno negativo describe direcciones opuestas, no necesariamente palabras antónimas. Comparar los vecinos con sus usos reales en el texto da una interpretación lingüística a esa geometría.
La famosa analogía king − man + woman ≈ queen —rey menos hombre más mujer, aproximadamente reina; traducción para esta versión— usa un desplazamiento vectorial para buscar una palabra relacionada (Mikolov, Yih, & Zweig, 2013 (se abre en una pestaña nueva)). Su procedimiento habitual de búsqueda excluye las tres palabras de entrada de las respuestas, una decisión que afecta cómo interpretamos el resultado.
La misma geometría aprendida puede conservar estereotipos presentes en los textos de entrenamiento. Bolukbasi y sus colegas documentaron asociaciones de género y propusieron un método geométrico para mitigarlas (Bolukbasi et al., 2016 (se abre en una pestaña nueva)). Medir y reducir esas asociaciones exige más que observar una analogía llamativa; la nota 3 presenta un ejemplo concreto y hallazgos posteriores.
Un punto de partida, distintos usos
Volvamos a la frase inicial. El vector estático de bank reúne información aprendida de distintos usos. Cada aparición de ese identificador recupera la misma fila y deja la interpretación de esta frase al procesamiento posterior.
Las representaciones contextuales permiten al modelo ir más allá de ese punto de partida fijo. Después de la consulta inicial, las capas del modelo transforman los vectores usando el contexto al que pueden acceder. Comparemos «The fisherman rested on the bank» —el pescador descansaba en la orilla— con «The banker worked at the bank» —el banquero trabajaba en el banco— (traducciones para esta versión). Si bank es el mismo token en ambas frases, su vector almacenado no cambia. Las representaciones posteriores sí pueden ser diferentes porque las palabras anteriores son distintas.
La atención es una forma de combinar información entre posiciones, pero las representaciones contextuales no dependen necesariamente de ella. ELMo, presentado en 2018, utilizaba estados internos de un modelo de lenguaje bidireccional, que combina contexto a izquierda y derecha. Se construyó con redes LSTM (long short-term memory, memoria a corto y largo plazo). Estas procesan secuencias y mantienen un estado capaz de conservar información de pasos anteriores (Peters et al., 2018 (se abre en una pestaña nueva)). Es un ejemplo de cómo aprender representaciones que varían según el uso mediante otro mecanismo.
Importa qué contexto está disponible. Un modelo de lenguaje causal construye la representación de cada posición usando ese token y los anteriores, sin acceder a los posteriores; aquí «causal» se refiere a la dirección del flujo de información. En nuestra frase inicial, storm —tormenta, traducción para esta versión— no puede influir en la posición previa de bank bajo esa restricción; las posiciones posteriores sí pueden incorporar ambos. Los modelos bidireccionales permiten contexto de ambos lados (Vaswani et al., 2017 (se abre en una pestaña nueva), secciones 3.1–3.2 (se abre en una pestaña nueva); Peters et al., 2018 (se abre en una pestaña nueva)).
Si el tokenizador divide una palabra en varias piezas, las capas posteriores también pueden combinar información entre ellas. Ninguna fila individual de la tabla tiene que contener una interpretación terminada de la palabra completa. La posición también importa; los Transformers incorporan información sobre el orden, a la que volveremos cuando examinemos la arquitectura (Vaswani et al., 2017 (se abre en una pestaña nueva), sección 3.5 (se abre en una pestaña nueva)).
De vuelta a bank: ¿orilla o sucursal bancaria?
Ahora podemos seguir la frase sin comprimir todo en «las palabras se convierten en números». El tokenizador elige piezas. El vocabulario les da direcciones. Esas direcciones seleccionan vectores de una tabla ajustada durante el entrenamiento. El modelo dispone entonces de representaciones numéricas que puede transformar usando el contexto disponible.
La orilla del río y la sucursal inundada siguen siendo lecturas posibles de nuestra frase original. Conocer el mecanismo no elimina la ambigüedad; explica por qué un diccionario de vectores fijos dejaría trabajo pendiente. El lenguaje nos pide interpretar un uso, además de reconocer una pieza.
Eso nos deja un siguiente paso concreto. ¿Cómo permite la atención que una posición aproveche información de otras? Ya sabemos con qué va a trabajar: vectores que han aprendido algo del lenguaje y que pueden transformarse para este texto en particular.
Notas
-
Variantes de BPE y cobertura. BPE nació como algoritmo de compresión (Gage, 1994 (se abre en una pestaña nueva)). Sennrich et al. lo adaptan a caracteres, usan un marcador de fin de palabra y mantienen las fusiones dentro de cada palabra; esto difiere de la convención del espacio inicial de nuestro ejemplo. Su nota al pie 3 aborda los caracteres desconocidos. Un esquema basado en bytes que conserve los 256 valores posibles puede componer cualquier secuencia de bytes, aunque la cobertura por sí sola no asegura predicciones útiles (Sennrich et al., 2016, sección 3.2 (se abre en una pestaña nueva)). Volver a la tokenización.
-
Vectores one-hot y tablas de consulta. Si es el vector columna one-hot del identificador , entonces selecciona la fila de la matriz de embeddings. Todas las demás filas se multiplican por cero. Una consulta recupera directamente la misma fila sin construir un vector enorme compuesto casi por completo de ceros. Que la representación one-hot original no exprese similitud no impide que la tabla aprendida lo haga. Volver a los identificadores.
-
Analogías y medición de sesgos. En los experimentos de Nissim et al. con GoogleNews,
he : doctor :: she : ?devolvíanurseal excluir las palabras de entrada ydoctoral permitirlas, con dos métodos de puntuación, 3COSADD y 3COSMUL (él, médico, ella y enfermera son las traducciones para esta versión). Los autores también discuten la contribución de la estructura de vecindad al rendimiento: acertar una analogía no demuestra por sí solo una relación estable codificada en un desplazamiento. Estos límites de medición no niegan los sesgos documentados (Nissim et al., 2020, tabla 1 (se abre en una pestaña nueva)). En cuanto a la mitigación, Gonen y Goldberg encontraron asociaciones de género recuperables en los vecinos tras aplicar tanto Hard-Debias, el método de Bolukbasi, como GN-GloVe, otro enfoque de mitigación (Gonen & Goldberg, 2019 (se abre en una pestaña nueva)). Volver a la similitud.
Referencias
Bolukbasi, T., Chang, K.-W., Zou, J. Y., Saligrama, V., & Kalai, A. T. (2016). Man is to computer programmer as woman is to homemaker? Debiasing word embeddings. En D. Lee, M. Sugiyama, U. von Luxburg, I. Guyon, & R. Garnett (Eds.), Advances in Neural Information Processing Systems (Vol. 29, pp. 4349–4357). Curran Associates. Actas del congreso (se abre en una pestaña nueva)
Gage, P. (1994). A new algorithm for data compression. The C Users Journal, 12(2), 23–38. Artículo archivado (se abre en una pestaña nueva)
Gonen, H., & Goldberg, Y. (2019). Lipstick on a pig: Debiasing methods cover up systematic gender biases in word embeddings but do not remove them. En J. Burstein, C. Doran, & T. Solorio (Eds.), Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 1 (Long and Short Papers) (pp. 609–614). Association for Computational Linguistics. https://doi.org/10.18653/v1/N19-1061 (se abre en una pestaña nueva)
Mikolov, T., Chen, K., Corrado, G., & Dean, J. (2013). Efficient estimation of word representations in vector space [Prepublicación]. arXiv. https://arxiv.org/abs/1301.3781 (se abre en una pestaña nueva)
Mikolov, T., Yih, W.-t., & Zweig, G. (2013). Linguistic regularities in continuous space word representations. En L. Vanderwende, H. Daumé III, & K. Kirchhoff (Eds.), Proceedings of the 2013 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (pp. 746–751). Association for Computational Linguistics. ACL Anthology (se abre en una pestaña nueva)
Nissim, M., van Noord, R., & van der Goot, R. (2020). Fair is better than sensational: Man is to doctor as woman is to doctor. Computational Linguistics, 46(2), 487–497. https://doi.org/10.1162/coli_a_00379 (se abre en una pestaña nueva)
OpenAI. (2019). GPT-2 tokenizer (src/encoder.py) [Código fuente]. GitHub. encoder.py (se abre en una pestaña nueva)
Pennington, J., Socher, R., & Manning, C. D. (2014). GloVe: Global vectors for word representation. En A. Moschitti, B. Pang, & W. Daelemans (Eds.), Proceedings of the 2014 Conference on Empirical Methods in Natural Language Processing (EMNLP) (pp. 1532–1543). Association for Computational Linguistics. https://doi.org/10.3115/v1/D14-1162 (se abre en una pestaña nueva)
Peters, M. E., Neumann, M., Iyyer, M., Gardner, M., Clark, C., Lee, K., & Zettlemoyer, L. (2018). Deep contextualized word representations. En M. Walker, H. Ji, & A. Stent (Eds.), Proceedings of the 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 1 (Long Papers) (pp. 2227–2237). Association for Computational Linguistics. https://doi.org/10.18653/v1/N18-1202 (se abre en una pestaña nueva)
Sennrich, R., Haddow, B., & Birch, A. (2016). Neural machine translation of rare words with subword units. En K. Erk & N. A. Smith (Eds.), Proceedings of the 54th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) (pp. 1715–1725). Association for Computational Linguistics. https://doi.org/10.18653/v1/P16-1162 (se abre en una pestaña nueva)
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. En I. Guyon, U. von Luxburg, S. Bengio, H. Wallach, R. Fergus, S. Vishwanathan, & R. Garnett (Eds.), Advances in Neural Information Processing Systems (Vol. 30, pp. 5998–6008). Curran Associates. Actas del congreso (se abre en una pestaña nueva)