IA explicada
¿Qué es la atención y para qué sirve?
Sigue una palabra ambigua entre consultas, claves y valores para entender cómo la atención combina información del contexto y qué nos dicen sus pesos.
Artículo 4 de 5 · Orden de lectura
Imagina que encuentras la palabra bank en una página escrita en inglés. Podría ser un banco donde alguien guarda dinero o la orilla de un río. Ahora leamos un poco más: «The fisherman repaired his net beside the bank». El pescador reparaba su red junto a la orilla. Si cambiamos la frase por «The cashier counted the money inside the bank», aparece otra escena: la cajera contaba el dinero dentro del banco. Las traducciones ya eligen una interpretación que la palabra inglesa, por sí sola, dejaba abierta.
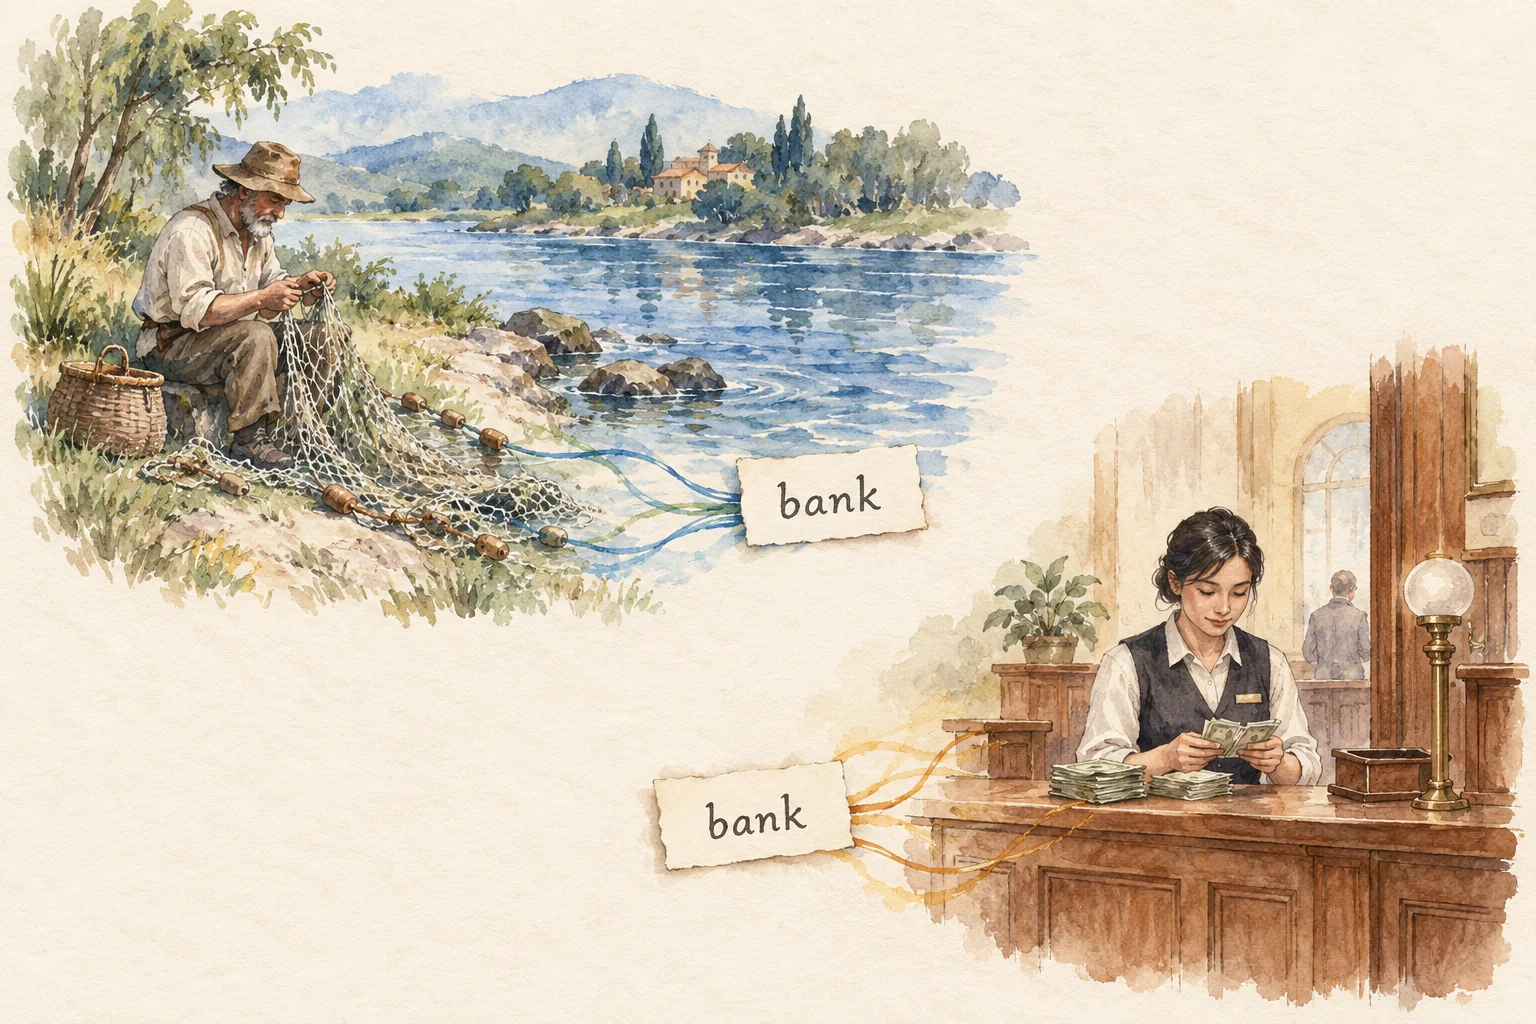
La misma palabra, distintas pistas alrededor: una ilustración conceptual del papel del contexto, no un mapa de atención medido.
Para nosotros, las palabras que la acompañan ofrecen pistas que la palabra sola no podría dar. Para un modelo, esas pistas tienen que participar en un cálculo. Ya encontramos bank y a un pescador en el artículo sobre tokens y embeddings, donde vimos cómo un identificador recupera un vector de una tabla. Si ambas apariciones de bank corresponden al mismo token, recuperan la misma fila. Lo que necesitamos ahora es una manera de incorporar información de esta frase particular.
La atención permite combinar información de distintas posiciones, dando a cada contribución un peso que depende de la consulta. Vamos a seguir esa operación desde la posición de bank: de dónde salen los números que se comparan, cómo se convierten en pesos y qué se obtiene al usarlos. Al terminar, podremos describir algo más concreto que «el modelo se fija en lo importante».
Una palabra necesita información de sus vecinas
Pensemos en una representación como una lista de números que una capa recibe y transforma. Al principio puede proceder de un embedding y de información de posición; más adelante puede contener información que otras capas ya combinaron. Nos interesa cómo llega a la posición de bank algo de lo que aportan fisherman y net.
Una posibilidad sería promediar todos los vectores por igual. Pero esa regla aportaría la misma mezcla a cada posición. La representación de bank, la de repaired y la de net podrían necesitar combinaciones diferentes. La atención permite calcular una mezcla para cada consulta.
Esa necesidad tuvo una aplicación influyente en traducción. Bahdanau, Cho y Bengio propusieron que, al generar una palabra de la traducción, el sistema pudiera combinar representaciones de distintas partes de la frase original. El trabajo circuló en 2014 y se presentó en ICLR 2015. Permitía obtener un contexto distinto en cada paso, en lugar de depender únicamente de un resumen fijo de toda la entrada (Bahdanau et al., 2015 (se abre en una pestaña nueva)).
En nuestro ejemplo, las posiciones que intercambian información pertenecen a una misma frase. A esto lo llamamos autoatención, o self-attention. Aquí seguiremos la variante por producto escalar escalado que utiliza el Transformer. Bahdanau y sus colegas usaron atención aditiva, que calcula la compatibilidad mediante una pequeña red feedforward. Ambas convierten puntuaciones en una mezcla ponderada; lo que cambia es cómo calculan esas puntuaciones. La atención también puede relacionar dos secuencias distintas, como veremos al volver a la traducción.
Tres papeles para los números: consulta, clave y valor
Imagina que buscas una nota en un archivo. Tienes un criterio de búsqueda, algo con lo que comparar ese criterio y un contenido que recuperar. Esa distinción ayuda a presentar tres papeles de la atención: consulta, clave y valor, conocidos por las iniciales inglesas Q, K y V (query, key, value). El límite de la analogía importa: aquí todo son vectores, y el resultado puede mezclar varias contribuciones en vez de recuperar una sola ficha.
En la autoatención que estamos siguiendo, cada posición produce los tres vectores a partir de su representación. La consulta participa en las comparaciones iniciadas desde esa posición. La clave participa cuando una consulta se compara con ella. El valor contiene los números que se incorporarán a la mezcla. Las claves ayudan a calcular cuánto aporta cada posición; los valores aportan el contenido numérico.
Para obtenerlos, se multiplica la representación de entrada por tres matrices de parámetros aprendidos. Si es el vector fila que recibe esta capa en la posición :
Cada matriz combina las coordenadas de entrada con sus propios coeficientes. Por eso, aunque partan de la misma representación, consulta, clave y valor pueden resultar distintos. Dentro de una cabeza de atención se aplican las mismas matrices a todas las posiciones. Esta construcción y la separación entre comparación y contenido aparecen en la atención del Transformer (Vaswani et al., 2017 (se abre en una pestaña nueva), sección 3.2 (se abre en una pestaña nueva)).
Para nuestra frase, seguiremos la consulta de bank. «¿Orilla o institución financiera?» describe nuestro problema de lectura; la consulta del modelo es un vector. Se comparará con las claves de las posiciones disponibles, incluida la suya.
De una comparación a una proporción
Necesitamos convertir cada comparación en un número. Retomamos el producto escalar del artículo anterior: multiplicar las coordenadas correspondientes de dos vectores y sumar los resultados. Para una consulta y una clave de dos dimensiones, sería . En la variante que seguimos, se divide además entre la raíz cuadrada del número de dimensiones de la clave:
Aquí es la posición que consulta, la posición consultada y la cantidad de coordenadas de cada consulta y clave. La división modera la escala de las puntuaciones; la nota 1 explica el motivo. A diferencia del coseno que usamos para explorar embeddings, este cálculo no divide entre las longitudes de los dos vectores: sus magnitudes también cuentan.
Hagamos un ejemplo que podamos comprobar a mano. Todos los números son inventados. Supondremos un token por palabra y reduciremos el cálculo a tres posiciones, fisherman, net y bank, para poder ver la operación completa con tres contribuciones disponibles.
Elijamos la consulta para bank y estas claves, con :
| Token | ||
|---|---|---|
fisherman |
2 | |
net |
1 | |
bank |
0 |
Por ejemplo, el producto con la clave de fisherman es . Al dividir entre obtenemos la puntuación 2 de la tabla.
Las puntuaciones son 2, 1 y 0. Ahora queremos proporciones positivas que sumen uno, de modo que podamos utilizarlas para ponderar una mezcla. Softmax eleva la constante —aproximadamente 2.718— a cada puntuación y divide cada resultado entre la suma de todos:
Los valores mostrados están redondeados; antes de redondear suman uno. La puntuación cero tampoco desaparece: . En este ejercicio, fisherman recibe la mayor proporción, pero las tres posiciones contribuyen. Las diferencias entre puntuaciones determinan cómo se reparte el peso entre los valores (Vaswani et al., 2017 (se abre en una pestaña nueva), sección 3.2.1 (se abre en una pestaña nueva)).
Ese 0.6652 no significa «hay un 66.52 % de probabilidad de que bank sea una orilla». Describe cuánto se ponderará uno de los valores en este cálculo. Su magnitud depende de esta consulta, estas claves y las posiciones con las que compite.
Los valores son lo que viaja
Ya sabemos cuánto va a contribuir cada posición. Falta decidir qué números combina la operación. Para eso estaban los valores. Asignemos a fisherman, a net y a bank, sin etiquetas lingüísticas para sus coordenadas.
Multiplicamos cada vector por su peso y sumamos coordenada a coordenada:
El resultado final usa los pesos sin redondear. La primera coordenada recoge sobre todo la contribución que asignamos a fisherman; la segunda recibe una contribución mayor de net. Si hubiéramos usado pesos iguales, obtendríamos . La diferencia permite ver qué cambió al ponderar las contribuciones.
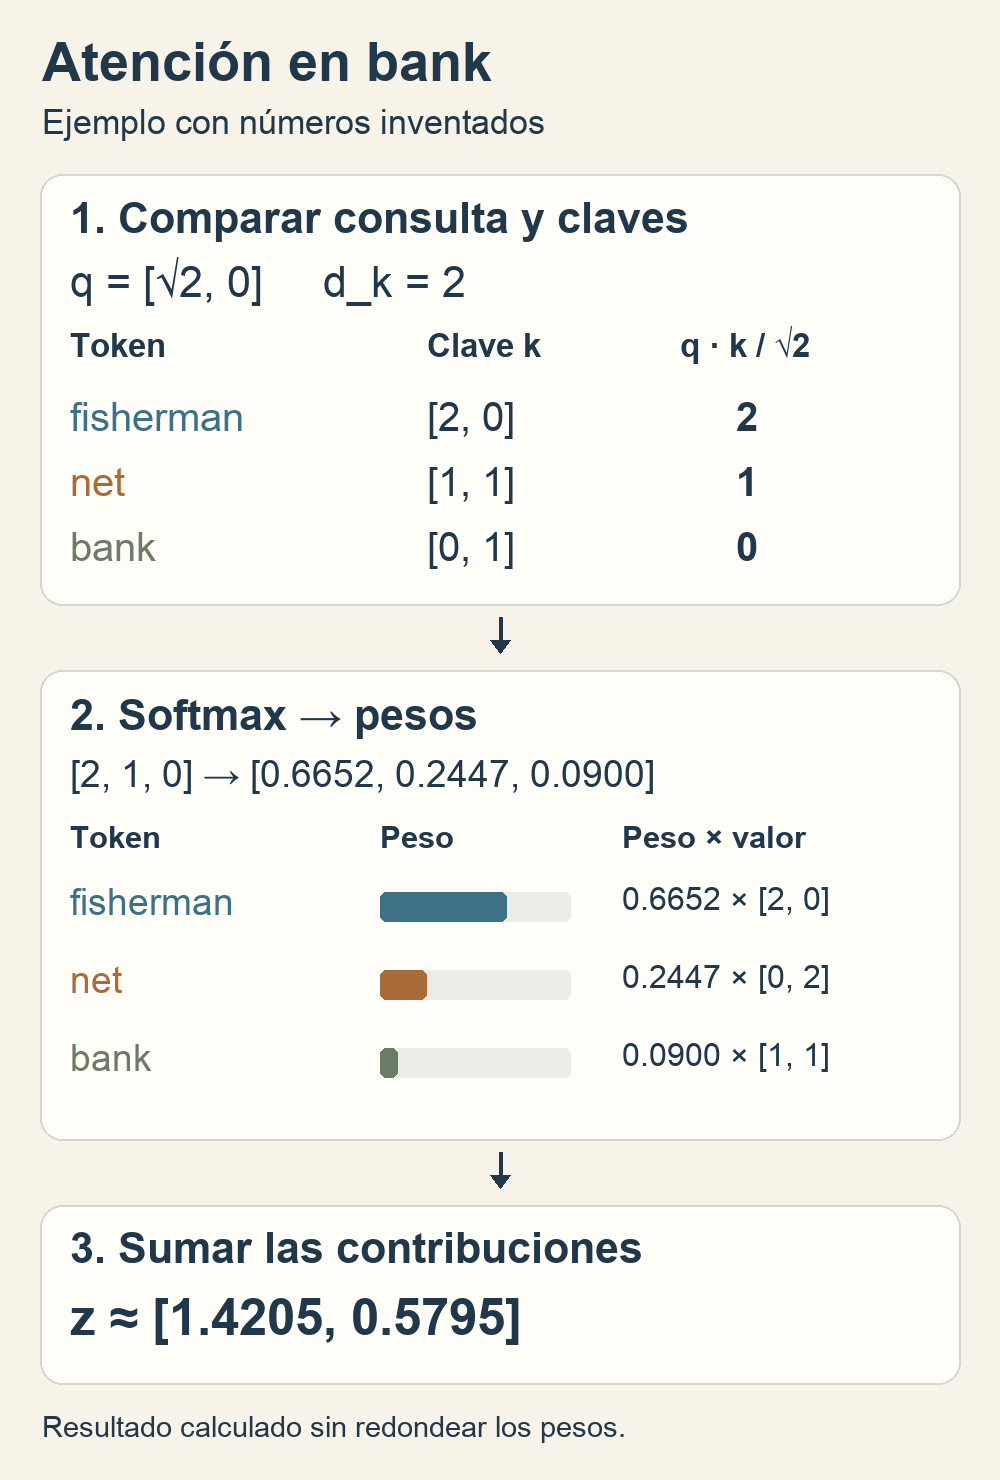
El cálculo completo de una cabeza para una posición, reducido a tres contribuciones inventadas. Las barras representan pesos de la mezcla; el resultado usa los pesos sin redondear.
Esta es la salida de una cabeza de atención para una posición. Hemos construido una representación usando información de otras posiciones, pero todavía no hemos producido la palabra «orilla» ni una clasificación. Las capas posteriores pueden aprovechar ese resultado para la tarea del modelo. La nota 2 muestra cómo escribir el mismo procedimiento para todas las posiciones mediante matrices.
Ahora sustituye la escena del pescador por la de la cajera. Cambian las representaciones de las palabras que lo rodean y, con ellas, sus claves y valores. Si mantenemos bank como el mismo token en la misma posición de ambas frases, en este planteamiento conserva su representación inicial y su consulta de la primera capa. Aun así, esa consulta puede recibir una mezcla distinta de sus nuevas vecinas. En capas posteriores también puede cambiar la consulta de bank, porque su representación ya ha incorporado contexto. Así, una misma fila de la tabla de embeddings puede dar lugar a representaciones contextuales diferentes.
Qué aprende el modelo y qué calcula al leer
Puede parecer que elegimos los números justos para obtener la mezcla deseada. Eso es exactamente lo que hicimos para explicar el cálculo. Durante el entrenamiento de un modelo, en cambio, las matrices , y se ajustan mediante la señal de error de la tarea, junto con los demás parámetros. El artículo sobre redes neuronales desarrolla ese ciclo de predicción y ajuste.
Conviene distinguir aquí dos usos de la palabra peso. Los coeficientes de esas matrices son parámetros aprendidos, que la inferencia habitual conserva. Los pesos de atención, como 0.6652, son resultados del cálculo para una entrada particular. Pueden cambiar cuando cambia el texto aunque los parámetros del modelo sigan siendo los mismos.
Esa distinción nos devuelve a la escena inicial: el modelo puede procesar una frase sobre un río y después otra sobre dinero sin reentrenarse entre ambas. Aplica las transformaciones que aprendió a entradas diferentes. Su entrenamiento busca que esas transformaciones resulten útiles; las pruebas con nuevos ejemplos permiten evaluar hasta dónde lo son.
Varias mezclas para una misma palabra
Nuestra mezcla dio a fisherman un peso aproximado de 0.6652 y a net, de 0.2447. Los pesos completos suman uno: dar más peso a una posición deja menos para las demás. Si quisiéramos una segunda mezcla que destacara net, cambiar esta distribución modificaría también el resultado que acabamos de calcular.
Una segunda cabeza tiene sus propias , y . Supongamos que sus consultas y claves producen las puntuaciones para esas mismas tres posiciones: hemos intercambiado deliberadamente las puntuaciones de fisherman y net. Softmax intercambia también sus pesos, así que net recibe ahora alrededor de 0.6652 en esta cabeza, mientras la primera conserva su mezcla original. Cada cabeza reparte su propio total de uno. Las dos mezclas quedan disponibles a la vez, y cada una puede transportar información mediante su propia proyección de valores.
La atención con múltiples cabezas, o multi-head attention, concatena esos resultados y aplica una proyección de salida para combinarlos (Vaswani et al., 2017 (se abre en una pestaña nueva), sección 3.2.2 (se abre en una pestaña nueva)). Su utilidad está en conservar varias combinaciones con ponderaciones distintas para ese siguiente paso. Qué relaciones transporta cada cabeza surge del aprendizaje y puede investigarse en el modelo entrenado.
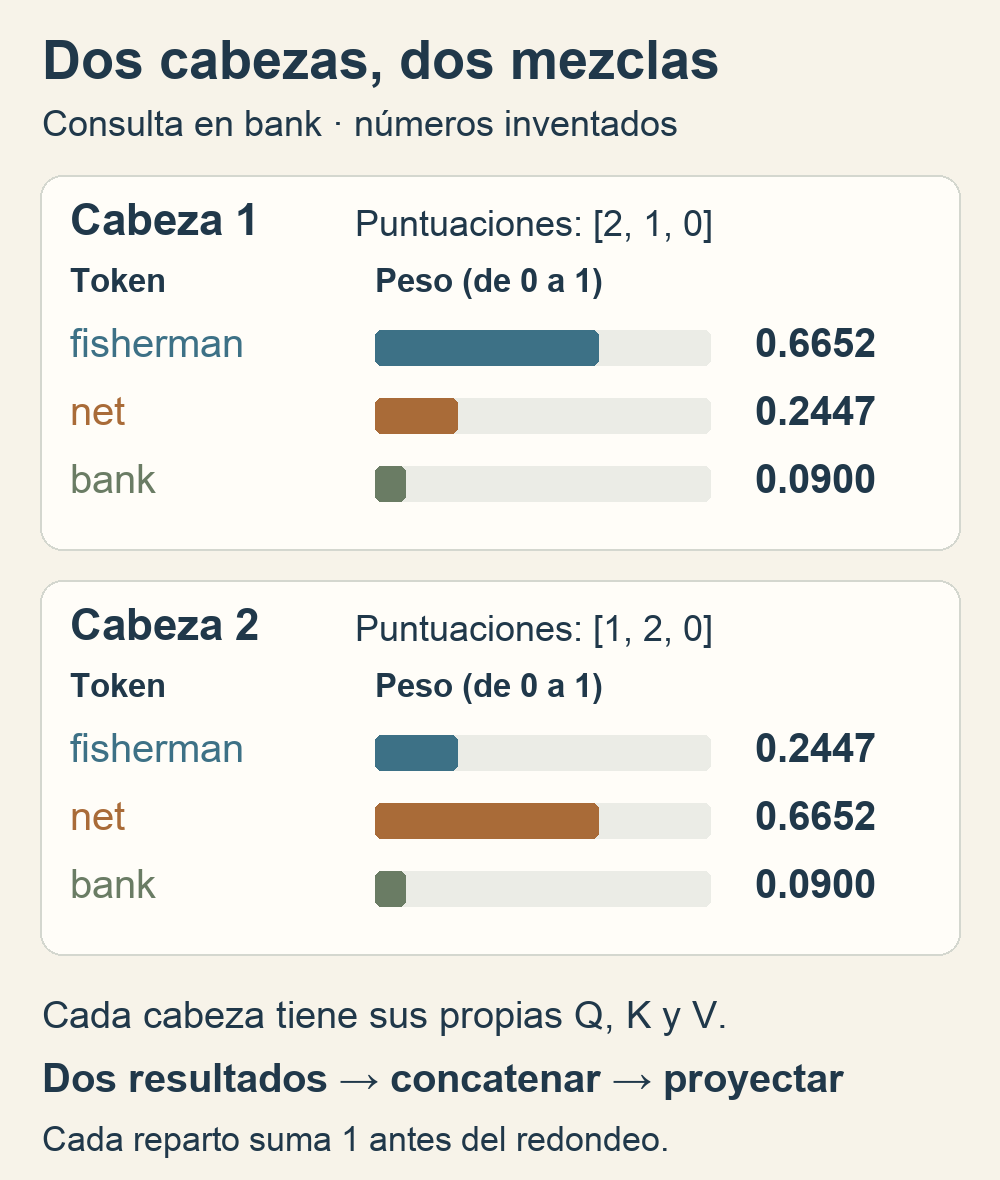
Dos mezclas normalizadas por separado, con las puntuaciones inventadas de nuestro ejemplo. Los pesos de cada cabeza suman uno antes del redondeo; sus salidas se concatenan y se proyectan.
¿Qué posiciones pueden contribuir?
El artículo anterior introdujo la restricción causal en los modelos de lenguaje: una posición puede usar la suya y las anteriores. Ahora podemos situar esa restricción dentro del cálculo de atención. Una máscara excluye las posiciones posteriores antes de softmax, de modo que reciben peso cero. En nuestra frase, fisherman y net preceden a bank, así que ambos siguen disponibles.
Volvamos a «The bank flooded after the storm». Con esa máscara causal, la consulta de bank no puede usar la clave ni el valor de la posición posterior de storm. Una consulta en storm sí puede combinar información de ambas. El artículo anterior también presentó modelos bidireccionales, que permiten contexto de ambos lados. En la autoatención bidireccional, bank puede acceder a la pista posterior. Aun así, la frase podría describir una orilla o una sucursal bancaria inundadas: si las pistas son insuficientes, el modelo sigue teniendo un problema por resolver.
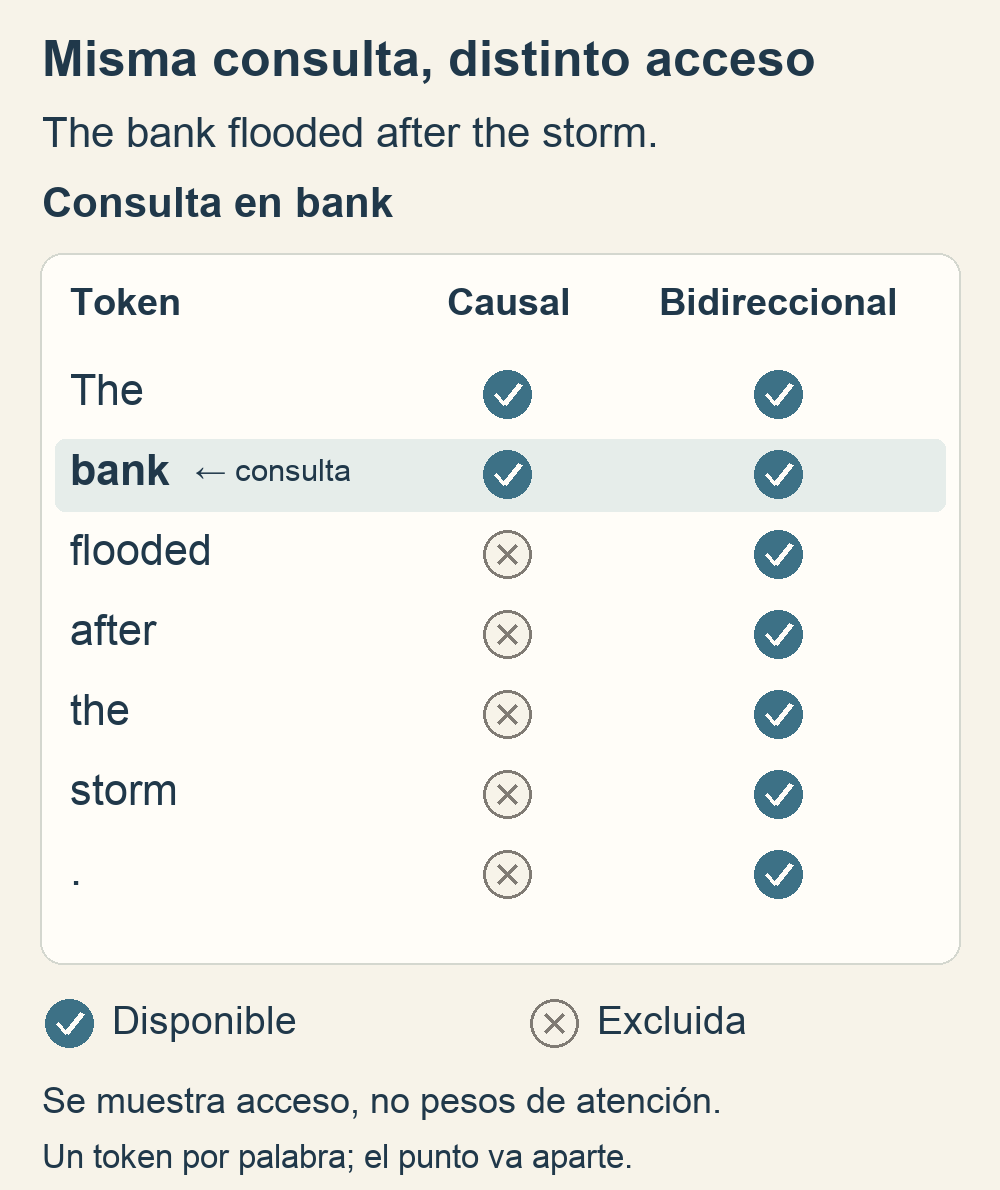
Posiciones disponibles para una misma consulta. Las marcas muestran acceso, no pesos de atención. Suponemos un token por palabra y otro para el punto.
En la atención cruzada, o cross-attention, las consultas proceden de una secuencia y las claves y los valores de otra. En traducción, una representación de la salida puede consultar representaciones de la entrada (Vaswani et al., 2017 (se abre en una pestaña nueva), sección 3.2.3 (se abre en una pestaña nueva)). Esto nos devuelve a Bahdanau y sus colegas: su mecanismo de traducción también conectaba la salida en construcción con representaciones de la frase original, usando puntuaciones aditivas. Cambia el origen de la información; se conserva la idea de calcular una mezcla según una consulta.
Un mapa de atención invita a mirar, pero también a comprobar
Si pintamos cada peso con una intensidad de color, obtenemos un mapa fácil de observar. Sería tentador señalar la casilla más oscura y decir: «Aquí está la razón de la respuesta». Nuestro cálculo ya muestra una dificultad: el peso solo es una parte de la contribución; también importa el vector al que multiplica y lo que el resto del modelo hace con el resultado.
Hay evidencia directa para mirar más allá de los pesos en Transformers. Kobayashi y sus colegas analizaron BERT y un sistema de traducción basado en Transformer usando tanto los pesos de atención como las normas de los vectores de entrada transformados, incluidas las proyecciones de valor y de salida. Aquí la norma mide la longitud de un vector: un peso grande que multiplica un vector corto puede aportar menos de lo que sugiere el peso por sí solo. En los modelos BERT que estudiaron, los tokens especiales, como el separador [SEP], contribuían mucho menos a la salida de atención de lo que sugerían sus pesos altos, porque sus vectores transformados tenían normas pequeñas (Kobayashi et al., 2020 (se abre en una pestaña nueva)).
Un debate relacionado estudió otra arquitectura. En experimentos centrados en codificadores recurrentes bidireccionales (BiLSTM) con una sola capa de atención, Jain y Wallace construyeron, mediante optimización, distribuciones de atención muy distintas que mantenían predicciones prácticamente iguales en clasificación, respuesta a preguntas e inferencia de lenguaje natural (Jain & Wallace, 2019 (se abre en una pestaña nueva)). Wiegreffe y Pinter retomaron clasificadores LSTM y propusieron pruebas adicionales, incluida la posibilidad de que un modelo entrenado produjera las distribuciones alternativas (Wiegreffe & Pinter, 2019 (se abre en una pestaña nueva)). Esos resultados no resuelven la interpretabilidad de la autoatención multicabeza; muestran por qué la arquitectura, la intervención y el significado de «explicación» deben formar parte de la pregunta.
Para un modelo entrenado que procesara nuestra frase, un mapa podría sugerir una relación que investigar. Para comprobar si la información de fisherman ayuda a resolver bank, podríamos cambiar pistas del texto o intervenir en la contribución de una cabeza y medir cómo cambia la salida. El mapa ayudaría a formular una hipótesis; el experimento la pondría a prueba.
Volver a la orilla con una operación en la mano
Al principio teníamos una palabra que admitía dos escenas. Ahora podemos seguir una vía por la que el contexto participa en su representación: una consulta se compara con claves, las puntuaciones se convierten en pesos y esos pesos combinan valores. El resultado lleva a una posición información de otras, en una proporción que depende del texto y de las transformaciones aprendidas.
La frase del pescador nos ayuda a imaginar para qué sirve; el pequeño cálculo nos permite ver cómo ocurre. Ahora podemos preguntar qué pistas están disponibles, cómo se mezclan sus contribuciones y qué cambia cuando las modificamos.
Queda por entender cómo se integra esta operación en una red completa, cómo se conserva información entre capas y cómo se representa el orden de la frase. Ese será nuestro recorrido por el Transformer. Por ahora, cuando leamos que un modelo «presta atención», podemos imaginar algo concreto: números que comparan, ponderan y transportan información.
Notas
-
Por qué dividir entre una raíz. Bajo la suposición ilustrativa de que las componentes de consulta y clave son independientes, con media cero y varianza uno, su producto escalar tiene varianza . Dividir entre mantiene esa varianza en uno. Esto ayuda a evitar que las puntuaciones crezcan con la dimensión y lleven softmax a regiones con gradientes muy pequeños. Es la motivación del escalado, no una garantía de que los vectores aprendidos satisfagan esas suposiciones (Vaswani et al., 2017 (se abre en una pestaña nueva), sección 3.2.1 (se abre en una pestaña nueva)). Volver a las puntuaciones.
-
El mismo cálculo en matrices. Sea la matriz con las representaciones de posiciones, cada una con coordenadas. Con y obtenemos , y . Así, y . La matriz de puntuaciones tiene forma . Aplicar softmax por fila y multiplicar por da : una mezcla por consulta. Una máscara causal añade a las puntuaciones prohibidas antes de softmax, de modo que reciben peso cero. La fórmula describe una cabeza; el número de dimensiones de los valores, , puede diferir de (Vaswani et al., 2017 (se abre en una pestaña nueva), sección 3.2 (se abre en una pestaña nueva)). Volver a los valores.
Referencias
Bahdanau, D., Cho, K., & Bengio, Y. (2015, 7–9 de mayo). Neural machine translation by jointly learning to align and translate [Presentación de ponencia]. 3rd International Conference on Learning Representations, San Diego, California, Estados Unidos. Manuscrito de la época del congreso, arXiv v6 (24 de abril de 2015) (se abre en una pestaña nueva)
Jain, S., & Wallace, B. C. (2019). Attention is not explanation. En J. Burstein, C. Doran, & T. Solorio (Eds.), Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 1 (Long and Short Papers) (pp. 3543–3556). Association for Computational Linguistics. https://doi.org/10.18653/v1/N19-1357 (se abre en una pestaña nueva)
Kobayashi, G., Kuribayashi, T., Yokoi, S., & Inui, K. (2020). Attention is not only a weight: Analyzing Transformers with vector norms. En B. Webber, T. Cohn, Y. He, & Y. Liu (Eds.), Proceedings of the 2020 Conference on Empirical Methods in Natural Language Processing (EMNLP) (pp. 7057–7075). Association for Computational Linguistics. https://doi.org/10.18653/v1/2020.emnlp-main.574 (se abre en una pestaña nueva)
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. En I. Guyon, U. von Luxburg, S. Bengio, H. Wallach, R. Fergus, S. Vishwanathan, & R. Garnett (Eds.), Advances in Neural Information Processing Systems (Vol. 30, pp. 5998–6008). Curran Associates. Actas del congreso (se abre en una pestaña nueva)
Wiegreffe, S., & Pinter, Y. (2019). Attention is not not explanation. En K. Inui, J. Jiang, V. Ng, & X. Wan (Eds.), Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing and the 9th International Joint Conference on Natural Language Processing (EMNLP-IJCNLP) (pp. 11–20). Association for Computational Linguistics. https://doi.org/10.18653/v1/D19-1002 (se abre en una pestaña nueva)