IA explicada
¿De qué aprende un modelo? Los datos de entrenamiento
De una colección de dígitos escritos a mano a un corpus de texto: cómo la procedencia, la selección, los duplicados y los ejemplos ausentes influyen en el aprendizaje y su evaluación.
Artículo 6 de 6 · Orden de lectura
Imagina que queremos enseñar a una computadora a reconocer números escritos a mano. Reunimos páginas de un cuaderno, recortamos los dígitos y entrenamos una red. Probamos con más recortes del mismo cuaderno y los resultados parecen buenos. Entonces alguien escribe un 3 en una servilleta, le toma una foto con el teléfono y el modelo se equivoca.
El 3 nos resulta bastante claro. ¿Qué cambió para la computadora?
Podrían haber cambiado la letra, la iluminación, el fondo o la forma de recortar la imagen. Cuando los datos que encuentra un modelo tienen características o frecuencias distintas de las que vio al entrenarse, hablamos de cambio de distribución (distribution shift) (Geirhos et al., 2020 (se abre en una pestaña nueva)). Quizás nuestra colección nunca le dio suficientes oportunidades de reconocer un dígito en esas condiciones. Esta escena es imaginaria, pero permite volver al 3 que seguimos a través de una red neuronal y mirar algo que entonces dimos por preparado: los ejemplos.
En la entrega sobre Transformer recorrimos una arquitectura capaz de relacionar las partes de una secuencia. Ahora vamos a detenernos antes de usarla: ¿qué material le entregamos para aprender? Al terminar, podrás explicar cómo seleccionar ejemplos y por qué su calidad, sus repeticiones y sus ausencias afectan tanto el aprendizaje como la manera de comprobarlo.
El mismo 3, en otras condiciones: cambian el papel, las arrugas y la luz. Ilustración conceptual de la escena que abre el artículo.
El cuaderno ya contenía decisiones
Para nuestro reconocedor, cada ejemplo puede ser una imagen acompañada del número que debería identificar. La imagen es la entrada; ese número es la etiqueta, la respuesta de referencia con la que comparamos la predicción. Al reunir muchos pares de este tipo construimos un conjunto de datos, o dataset. La parte que usamos para ajustar los parámetros será el conjunto de entrenamiento.
Parece una tarea sencilla: juntar imágenes y anotar números. Pero alguien tuvo que decidir quién escribiría, qué cámara usar, cuánto espacio dejar alrededor del dígito y qué hacer con un trazo que una persona interpreta como 3 y otra como 8. También tuvo que revisar que el recorte y su etiqueta siguieran juntos. Una etiqueta equivocada convierte una imagen perfectamente legible en una señal de aprendizaje contradictoria.
Antes de recolectar más, conviene precisar qué queremos reconocer. ¿Dígitos centrados de un formulario escaneado? ¿Fotos tomadas a mano, con sombras y papel doblado? En el segundo caso, llenar la carpeta con más páginas del mismo cuaderno deja intacta buena parte de la dificultad. Podemos aumentar el número de archivos sin ampliar mucho las situaciones que representan.
Llamaremos representatividad a esa relación entre los ejemplos reunidos y las condiciones para las que queremos usar el modelo. En nuestra escena, necesitamos variedad de escritura y de captura pertinente para ese uso. Decidir qué variedad importa exige describir el destino del sistema.
Elegir ejemplos también forma parte de construir un modelo. Ilustración conceptual; las tarjetas no pertenecen a un conjunto de datos real.
Cuando el fondo ayuda demasiado
Supongamos ahora que, por comodidad, recortamos todos los 3 de un cuaderno cuadriculado y todos los 8 de hojas blancas. Hemos introducido una pista: el fondo ayuda a distinguir las etiquetas. Si esa pista se mantiene en los ejemplos de evaluación, un modelo podría aprovecharla y obtener buenos resultados aunque su reconocimiento del trazo sea frágil.
Esta posibilidad se estudia como aprendizaje de atajos: reglas que funcionan en las condiciones observadas y fallan al cambiar esas condiciones. Un análisis de Robert Geirhos y sus coautores examina este problema en redes profundas (Geirhos et al., 2020 (se abre en una pestaña nueva)).
Para investigar qué ocurre, podríamos mantener el mismo dígito y cambiar el fondo, o comparar resultados entre tipos de papel. Si las predicciones cambian mucho, tendríamos una pista para revisar. Repetir la comparación y controlar los demás cambios nos ayudaría a distinguir el efecto del fondo del efecto de la prueba misma.
Esta dificultad cambia también lo que entendemos por calidad. Si el uso previsto incluye fotografías con sombras, eliminar todas las imágenes con sombras puede dejar una colección más pulcra y menos útil. Nos interesa quitar archivos corruptos, corregir etiquetas equivocadas y conservar la dificultad que pertenece a la tarea. El 3 de la servilleta no debería desaparecer solo por ser menos fotogénico.
Cien copias no son cien experiencias distintas
Mientras ordenamos los recortes descubrimos que una imagen se guardó varias veces. Podríamos pensar que solo ocupa espacio. Sin embargo, si elegimos archivos al azar con la misma probabilidad para entrenar, cada copia le da a ese ejemplo otra oportunidad de participar en los ajustes.
Hagamos un cálculo pequeño. Partimos de cien imágenes distintas y añadimos noventa y nueve copias de una de ellas. Ahora hay 199 archivos, de los cuales cien muestran exactamente la misma imagen. Al muestrear uniformemente los archivos, esa imagen pasa de tener una probabilidad de selección del 1 % a ocupar aproximadamente la mitad de las selecciones esperadas. Hemos cambiado la frecuencia con que el modelo encuentra esa imagen. La nota 1 muestra cómo aparece esa repetición en un promedio de pérdidas.
En una colección de textos puede ocurrir algo parecido cuando distintas páginas reproducen el mismo documento o comparten pasajes extensos. Deduplicar consiste en detectar y tratar esas repeticiones. Un ejemplo es Colossal Clean Crawled Corpus, una colección de textos extraídos de la web conocida como C4 (no el explosivo). En sus experimentos con modelos de lenguaje entrenados con esa colección, Katherine Lee y sus colaboradores redujeron aproximadamente a una décima parte la proporción de tokens generados que formaban parte de pasajes memorizados. Compararon modelos entrenados con el corpus original y con versiones deduplicadas, generando texto sin proporcionarles un comienzo (Lee et al., 2022, sección 6.2 (se abre en una pestaña nueva)).
Tampoco conviene borrar todo lo que se parezca. Dos personas pueden escribir sendos 3 casi iguales y aportar ejemplos independientes; dos páginas pueden contener versiones de un mismo texto. Necesitamos decidir qué cuenta como duplicado y a qué escala lo buscamos. La nota 2 amplía esa distinción. En nuestro cuaderno, empezaríamos por rastrear qué recortes provienen de una misma captura.
Guardar ejemplos para una pregunta diferente
Ya tenemos una colección más variada y conocemos sus repeticiones. Aún falta decidir cómo sabremos si el modelo puede reconocer algo que no utilizó para aprender.
Se suelen separar tres funciones: entrenamiento, para ajustar parámetros; validación, para elegir configuraciones durante el desarrollo; y prueba, para evaluar la elección final con ejemplos reservados. Consultar repetidamente la prueba para tomar decisiones acaba incorporándola al desarrollo (scikit-learn developers, s. f. (se abre en una pestaña nueva)).
Para nuestro caso, poner archivos en tres carpetas no basta. Imaginemos que usamos una foto de un 3 para entrenar y guardamos una copia ligeramente recortada, con otro nombre, en la carpeta de prueba. Esa copia conserva casi todo el trazo, el fondo y la iluminación de la foto original. El modelo podría aprovechar esas coincidencias para acertar, aunque siga fallando ante un 3 escrito por otra persona. La prueba daría entonces una impresión demasiado favorable: parte de lo que presentamos como nuevo ya estuvo en el entrenamiento. Esto es un caso de fuga de datos, porque información que debía reservarse para evaluar el modelo entró en su aprendizaje. Cuando esa información son los propios ejemplos de evaluación, o copias de ellos, se habla de contaminación de la evaluación.
La separación debe responder a lo que queremos averiguar. Los recortes de una misma persona comparten hábitos de escritura y pueden estar relacionados entre sí: tratarlos como observaciones independientes pasa por alto esa relación. Si nos interesa reconocer la escritura de personas nuevas, separaríamos los datos por persona: todos los recortes de cada una irían a una sola partición. Ese es el motivo de separar grupos relacionados en los métodos de evaluación descritos por scikit-learn (scikit-learn developers, s. f., sección 3.1.2.4 (se abre en una pestaña nueva)). Si queremos medir qué ocurre con otra cámara, prepararíamos además una prueba que cambie esa condición.
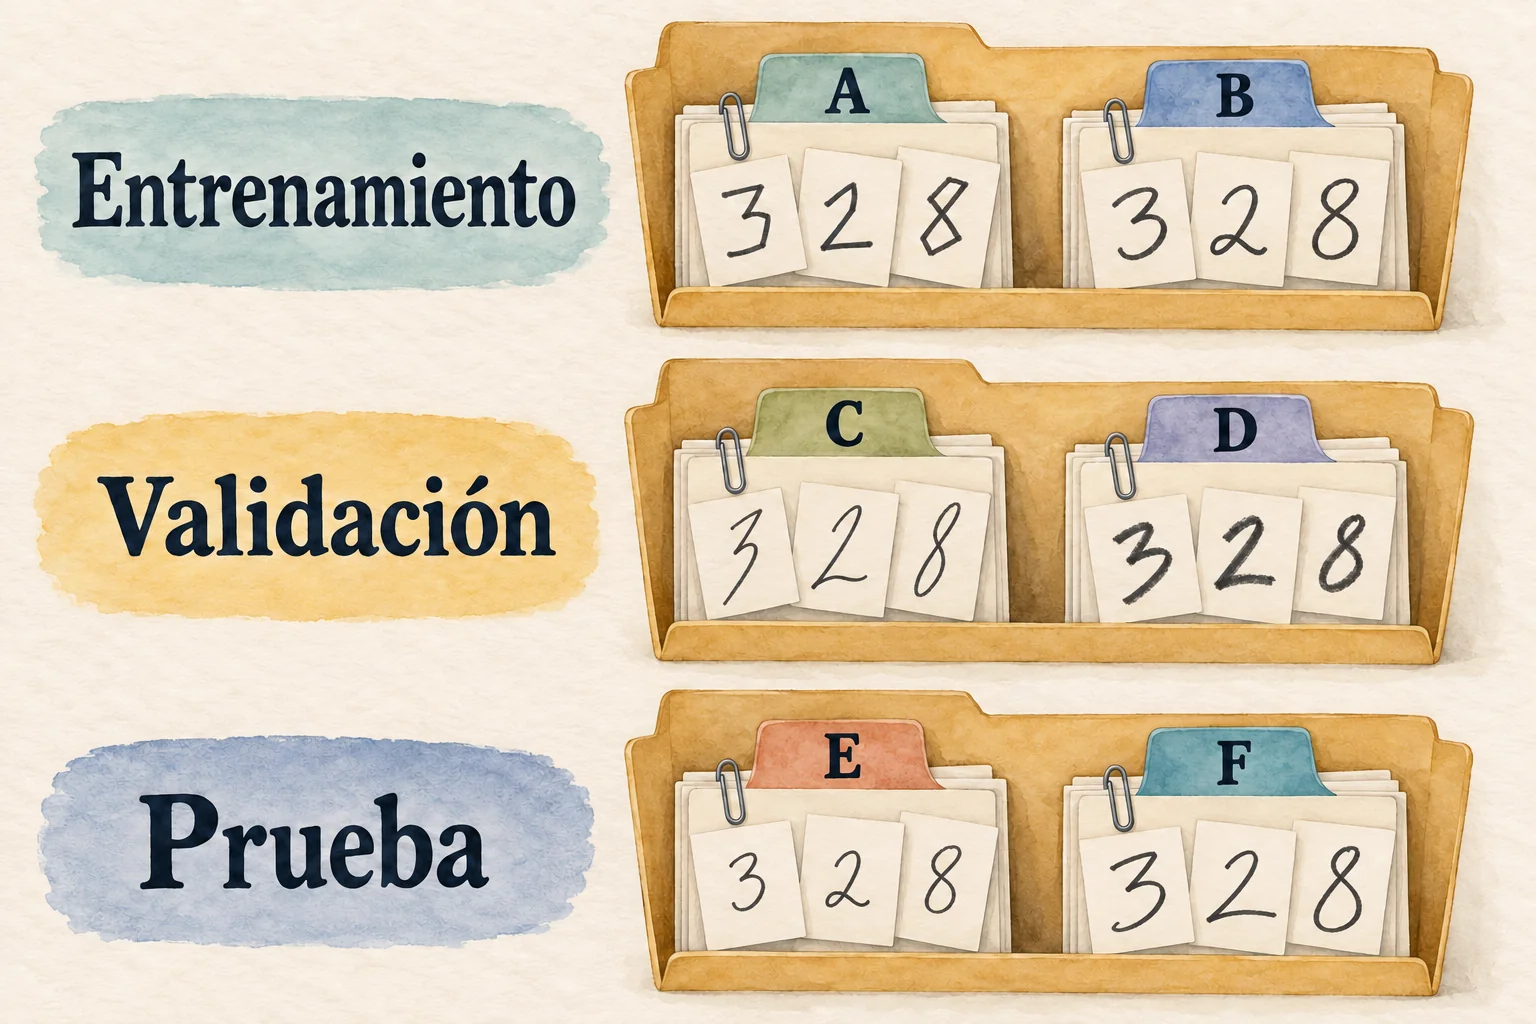
Cada letra representa a una persona. Los dígitos son los mismos —3, 2 y 8—, pero cambia la escritura; todos los recortes de cada persona permanecen en la misma partición. Así podemos evaluar la escritura de personas que no participaron en el entrenamiento. El esquema muestra el criterio de separación; el tamaño de cada partición se decide aparte.
Esta decisión tiene un precedente en MNIST, una colección de dígitos manuscritos. El Instituto Nacional de Estándares y Tecnología de Estados Unidos (NIST) había preparado imágenes de números escritos a mano para entrenamiento y prueba, pero sus procedencias eran distintas: las de entrenamiento venían de empleados de la Oficina del Censo y las de prueba, de estudiantes de secundaria. Yann LeCun y sus colegas mezclaron ambas procedencias para construir MNIST y reducir la dependencia de los resultados respecto a ese reparto. Al repartir las imágenes de los 500 estudiantes, asignaron los primeros 250 autores a entrenamiento y los otros 250 a prueba (LeCun et al., 1998, sección III.A (se abre en una pestaña nueva)). La procedencia y la identidad de quien escribe ya estaban cambiando la forma de evaluar.
Incluso con esa separación, un único porcentaje puede ocultar justo lo que nos preocupa. Imaginemos una prueba de cien imágenes: noventa limpias y diez con sombras. El modelo acierta las noventa primeras y solo dos de las otras diez. Obtiene una exactitud —proporción de aciertos— del 92 % en total, pero del 20 % en las imágenes con sombras. Si las sombras son habituales en el uso previsto, el promedio por sí solo cuenta una historia demasiado cómoda.
La prueba también necesita ejemplos suficientes de las condiciones que nos importan. Con solo diez imágenes, cada acierto mueve el resultado diez puntos porcentuales. La nota 3 muestra cuánta incertidumbre puede acompañar ese 20 %.
Del cuaderno a un corpus de texto
Llevemos ahora estas decisiones al lenguaje. En lugar de recortes reunimos documentos: artículos, manuales, conversaciones o código, según el propósito. Una colección organizada de textos recibe el nombre de corpus. Cambia el material, pero seguimos teniendo que decidir qué entra, cuánto se repite y qué reservamos para evaluar.
Hay una diferencia con nuestros dígitos etiquetados. Para ciertos objetivos de entrenamiento del lenguaje podemos obtener la respuesta de referencia del propio texto. En «El pescador se sentó en la orilla», por ejemplo, podemos usar un prefijo para predecir el token que le sigue, o esconder un fragmento y aprender a reconstruirlo. Como la respuesta de referencia sale del propio texto, este tipo de entrenamiento se llama aprendizaje autosupervisado. El trabajo de Colin Raffel y sus coautores compara objetivos de este tipo bajo el nombre de «objetivos no supervisados» (Raffel et al., 2020, sección 3.3 (se abre en una pestaña nueva)). Las palabras del ejemplo facilitan la lectura; el procesamiento utiliza tokens, que no siempre coinciden con palabras completas.
El texto proporciona una referencia para esa tarea, pero esa referencia no certifica la verdad de lo escrito. Una frase equivocada también tiene un token siguiente. Podemos preparar ejemplos para aprender regularidades del lenguaje sin que cada afirmación del corpus haya sido verificada. Esa diferencia será importante cuando nos preguntemos qué significa que un modelo sepa algo; por ahora, explica por qué la procedencia del material importa antes de entrenarlo.
Seguir un documento desde su origen ayuda a hacer concretas esas decisiones. Imaginemos una página con una explicación sobre pesca. Al extraerla podríamos arrastrar el menú, un aviso repetido y la recomendación de otros artículos. Después habría que reconocer el idioma, revisar si el contenido está completo, detectar copias y decidir a qué parte de nuestra colección pertenece. Cada transformación debería dejar suficiente rastro para saber qué conservamos y qué perdimos.
El corpus C4 ofrece un caso documentado: sus autores partieron de texto extraído de la web y aplicaron reglas de filtrado (Raffel et al., 2020, sección 2.2 (se abre en una pestaña nueva)). El nombre de una fuente de datos cuenta solo una parte de su historia; las reglas que se aplican después también determinan el material que llega al entrenamiento.
Lo que deja fuera un filtro
Podemos verlo en nuestra página imaginaria. Una regla que elimine menús repetidos parece razonable; una que descarte textos breves podría llevarse también una explicación concisa y valiosa. Si preferimos siempre un registro formal, podríamos reducir la presencia del lenguaje cotidiano que luego esperamos que el modelo maneje.
Un estudio sobre C4, firmado por Jesse Dodge junto con otros investigadores, encontró que el filtrado mediante una lista de palabras bloqueadas retiraba de manera desproporcionada textos de personas pertenecientes a minorías y textos sobre ellas (Dodge et al., 2021, secciones 5.2–5.3 (se abre en una pestaña nueva)).
Por eso, en nuestra colección de pesca revisaríamos tanto lo aceptado como una muestra de lo rechazado. ¿Estamos perdiendo el vocabulario de una región? ¿El detector de idioma descarta páginas que mezclan español e inglés? Hasta el «limpio» de Colossal Clean Crawled Corpus necesita esa inspección para cobrar sentido.
Un filtro también puede dejar pasar material que queríamos reservar. Ese mismo estudio detectó ejemplos de conjuntos de evaluación dentro de C4 (Dodge et al., 2021, sección 4.2 (se abre en una pestaña nueva)). Es la contaminación que vimos con el cuaderno, ahora a escala web: parte del material reservado para evaluar ya estaba entre los documentos disponibles para entrenar.
La deduplicación también alcanza ese límite entre carpetas. El estudio de Lee también encontró, mediante su método para detectar documentos casi duplicados, que el 4.6 % de los ejemplos de validación de C4 tenían un duplicado aproximado en entrenamiento (Lee et al., 2022, tabla 2 (se abre en una pestaña nueva)). Comparar las particiones entre sí permite localizar el equivalente textual de aquel recorte guardado en dos carpetas.
También decidiríamos con qué frecuencia presentar cada fuente. Supongamos que, después de filtrar, tenemos 900 manuales y 100 conversaciones. Si elegimos documentos uniformemente y con reemplazo —un documento puede volver a salir—, las conversaciones representan el 10 % de las selecciones esperadas. Si primero elegimos la fuente y reservamos un 30 % para conversaciones, en 1 000 selecciones esperamos unas 300 conversaciones en lugar de 100. Dentro de esa fuente seguimos eligiendo uniformemente: cada una de las mismas cien conversaciones aparece, en promedio, tres veces en lugar de una. A los 900 manuales les quedan 700 selecciones: cada uno pasa de una aparición esperada a unas 0.78 (700/900). Hemos aumentado la exposición de las conversaciones a costa de la de los manuales, manteniendo cien conversaciones distintas. Es la diferencia entre conseguir otros cuadernos y fotocopiar el primero.
Una colección que pueda explicarse
Al terminar este recorrido, la carpeta de imágenes o documentos ya viene acompañada de una historia: de dónde salió, qué seleccionamos, cómo resolvimos las ambigüedades y qué dejamos fuera. Si otra persona recibe solo los archivos, tendrá que adivinar buena parte de ella.
La propuesta de fichas de datos, o datasheets for datasets, presentada por Timnit Gebru junto con otros investigadores, busca documentar la motivación, la composición, la recolección, el preprocesamiento —incluidos limpieza y etiquetado—, los usos, la distribución y el mantenimiento de una colección (Gebru et al., 2021 (se abre en una pestaña nueva); manuscrito accesible (se abre en una pestaña nueva)).
Aplicado a nuestro proyecto, ese marco permitiría reconstruir qué personas y condiciones aportaron los dígitos, qué permisos se registraron, cómo se asignaron las etiquetas y qué versiones quedaron en cada partición. Para el corpus añadiríamos las fuentes, las condiciones de uso documentadas y las transformaciones aplicadas. Cuando un dato no se conoce, dejarlo explícito conserva una pregunta que de otro modo quedaría escondida.
Esa trazabilidad permite investigar el próximo error. Si el modelo falla ante una foto, podemos preguntar si esa condición estuvo representada, si el procesamiento alteró el trazo o si nuestra evaluación ya advertía la dificultad. La ficha nos da lugares concretos donde buscar.
Volver al 3 de la servilleta
La escena del principio sigue siendo la misma: una persona ve un 3 y la computadora se equivoca. Ahora tenemos un camino para investigar ese posible cambio de distribución. Podemos revisar los ejemplos de entrenamiento, las pistas accidentales, las repeticiones y la forma en que se construyó la prueba. Quizás necesitemos otras imágenes; quizás el problema esté en el recorte o en el modelo. Sabemos qué comparar para empezar a distinguir esas posibilidades.
También podemos mirar de otra manera una afirmación como «se entrenó con muchísimos datos». Nos interesará saber cuáles, seleccionados con qué criterios, repetidos cuánto y evaluados frente a qué situaciones. Esas preguntas dan contenido a una afirmación que, por sí sola, nos decía muy poco.
Ya hemos preparado el material y las condiciones para comprobar el aprendizaje. El siguiente paso será seguir cómo un modelo de lenguaje utiliza ese material para hacer predicciones y ajustar sus parámetros. Antes de ese cálculo hubo algo muy humano: alguien decidió qué ejemplos merecían entrar y qué significaría hacerlo bien.
Notas
-
La repetición dentro del promedio. En un objetivo que promedia por igual la pérdida de cada archivo, sean las pérdidas de nuestras cien imágenes, evaluadas con los mismos parámetros. Antes de copiar, el promedio es:
Al añadir 99 copias de la primera imagen, pasa a ser:
El coeficiente de pasa de a , aproximadamente el 50.3 % del peso total: la misma mitad que encontramos al contar archivos. Esto supone copias exactas, igual ponderación y el mismo procesamiento; un muestreo distinto cambia el cálculo. Tampoco implica que repetir durante varias épocas una colección completa tenga el mismo efecto que multiplicar solo un ejemplo. Volver a las copias.
-
Copias exactas y parecidas. Comparar hashes del contenido ayuda a localizar copias exactas; encontrar variantes requiere criterios de similitud. El trabajo de Lee aborda tanto documentos cercanos mediante MinHash como subcadenas repetidas mediante una estructura llamada suffix array (Lee et al., 2022, sección 4 (se abre en una pestaña nueva)). El umbral y la unidad de comparación importan: no es lo mismo retirar una página duplicada que un pasaje compartido. Volver a la deduplicación.
-
La incertidumbre de diez imágenes. Si las diez imágenes se obtuvieran como observaciones independientes de una misma población y cada predicción tuviera la misma probabilidad de acierto, 2 aciertos de 10 darían un intervalo binomial exacto de Clopper–Pearson del 95 % de aproximadamente 2.5 % a 55.6 %. El método procede de Clopper y Pearson (1934) (se abre en una pestaña nueva); SciPy developers (s. f.) (se abre en una pestaña nueva) documentan una implementación. Ese intervalo muestra la poca precisión de la estimación con una muestra tan pequeña. El 95 % describe la cobertura del procedimiento al repetir el muestreo; no asigna una probabilidad al parámetro después de observar los datos. Si varias imágenes comparten escritor o captura, debemos tratar esa dependencia al estimar la incertidumbre. Volver a la evaluación.
Referencias
Clopper, C. J., & Pearson, E. S. (1934). The use of confidence or fiducial limits illustrated in the case of the binomial. Biometrika, 26(4), 404–413. https://doi.org/10.1093/biomet/26.4.404 (se abre en una pestaña nueva)
Dodge, J., Sap, M., Marasović, A., Agnew, W., Ilharco, G., Groeneveld, D., Mitchell, M., & Gardner, M. (2021). Documenting large webtext corpora: A case study on the Colossal Clean Crawled Corpus. En M.-F. Moens, X. Huang, L. Specia, & S. W.-t. Yih (Eds.), Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing (pp. 1286–1305). Association for Computational Linguistics. https://doi.org/10.18653/v1/2021.emnlp-main.98 (se abre en una pestaña nueva)
Gebru, T., Morgenstern, J., Vecchione, B., Vaughan, J. W., Wallach, H., Daumé, H., III, & Crawford, K. (2021). Datasheets for datasets. Communications of the ACM, 64(12), 86–92. https://doi.org/10.1145/3458723 (se abre en una pestaña nueva). Manuscrito de los autores (se abre en una pestaña nueva)
Geirhos, R., Jacobsen, J.-H., Michaelis, C., Zemel, R., Brendel, W., Bethge, M., & Wichmann, F. A. (2020). Shortcut learning in deep neural networks. Nature Machine Intelligence, 2(11), 665–673. https://doi.org/10.1038/s42256-020-00257-z (se abre en una pestaña nueva). Prepublicación de los autores (se abre en una pestaña nueva)
LeCun, Y., Bottou, L., Bengio, Y., & Haffner, P. (1998). Gradient-based learning applied to document recognition. Proceedings of the IEEE, 86(11), 2278–2324. https://doi.org/10.1109/5.726791 (se abre en una pestaña nueva). Copia de los autores (se abre en una pestaña nueva)
Lee, K., Ippolito, D., Nystrom, A., Zhang, C., Eck, D., Callison-Burch, C., & Carlini, N. (2022). Deduplicating training data makes language models better. En S. Muresan, P. Nakov, & A. Villavicencio (Eds.), Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) (pp. 8424–8445). Association for Computational Linguistics. https://doi.org/10.18653/v1/2022.acl-long.577 (se abre en una pestaña nueva)
Raffel, C., Shazeer, N., Roberts, A., Lee, K., Narang, S., Matena, M., Zhou, Y., Li, W., & Liu, P. J. (2020). Exploring the limits of transfer learning with a unified text-to-text transformer. Journal of Machine Learning Research, 21(140), 1–67. Artículo original (se abre en una pestaña nueva)
scikit-learn developers. (s. f.). Cross-validation: Evaluating estimator performance. scikit-learn. Recuperado el 4 de octubre de 2026 de la documentación del proyecto (se abre en una pestaña nueva).
SciPy developers. (s. f.). BinomTestResult.proportion_ci. SciPy v1.16.1 manual. Recuperado el 4 de octubre de 2026 de la documentación del proyecto (se abre en una pestaña nueva).
Personas mencionadas
Robert Geirhos
Investigador del comportamiento y la generalización de las redes neuronales. Su trabajo en colaboración sobre aprendizaje de atajos examina cómo los modelos aprovechan patrones que funcionan con datos conocidos, pero fallan cuando cambian las condiciones.
Fuentes
Katherine Lee
Investigadora de los datos de entrenamiento de modelos de lenguaje. Fue coautora de un estudio que mostró cómo deduplicar colecciones de texto podía reducir las respuestas memorizadas y el solapamiento entre datos de entrenamiento y evaluación.
Fuentes
Yann LeCun
Investigador en aprendizaje automático y visión por computadora, conocido por su trabajo en redes neuronales convolucionales. Su investigación sobre reconocimiento de dígitos manuscritos incluye LeNet y el conjunto de datos MNIST, que conecta el diseño del modelo con la preparación de ejemplos de entrenamiento y prueba.
Fuentes
Colin Raffel
Investigador del aprendizaje por transferencia en modelos de lenguaje. Fue coautor del estudio de T5, que comparó enfoques de entrenamiento dentro de un esquema de texto a texto y presentó la colección de textos C4.
Fuentes
Jesse Dodge
Investigador de conjuntos de datos para modelos de lenguaje y de su documentación. Su análisis de C4 en colaboración examinó los efectos del filtrado de textos web y la presencia de ejemplos de evaluación en los datos de entrenamiento.
Fuentes
Timnit Gebru
Investigadora en aprendizaje automático y documentación de sus conjuntos de datos. Fue coautora de Datasheets for Datasets, una propuesta para registrar la motivación, composición, recolección y usos previstos de una colección, de modo que otras personas puedan evaluar su idoneidad.
Fuentes